목차페이블 5.1은 과학 벤치 점수를 가장 크게 올렸습니다
투자사 밀레니엄의 내부 시스템에는 몇 년째 설명이 안 되는 희귀 크래시가 있었습니다. 엔지니어들이 달라붙어도, 어떤 모델을 돌려봐도 원인을 찾지 못했어요.
그 원인을 테스트 중이던 새 모델이 찾아냈습니다. 앤트로픽이 9월 1일 발표한 클로드 페이블 5.1입니다. 앤트로픽은 발표문에 이 일화를 실어, 오래 묵은 실전 문제를 푸는 능력을 앞세웠습니다.
앤트로픽은 쌍둥이로 발표했습니다. 페이블 5.1과 미토스 5.1. 앤트로픽 스스로 "같은 모델이지만 안전장치 수준이 다르다"고 못 박았어요. 가중치가 같은 한 모델을 두 개의 문으로 내보냈습니다. 페이블은 오늘부터 누구에게나, 미토스는 사이버 보안·생명과학 종사자용 신뢰 접근 프로그램으로만.
앤트로픽은 공식 트윗 스레드로 반나절 만에 조회 16.1만을 모았습니다. 발표문과 212쪽짜리 시스템 카드를 다 읽고, 숫자부터 깨알 조건까지 정리했습니다.
페이블 5.1은 과학 벤치 점수를 가장 크게 올렸습니다
벤치마크 표에서 페이블 5.1은 코딩보다 과학 연구 점수를 가장 크게 올렸습니다.
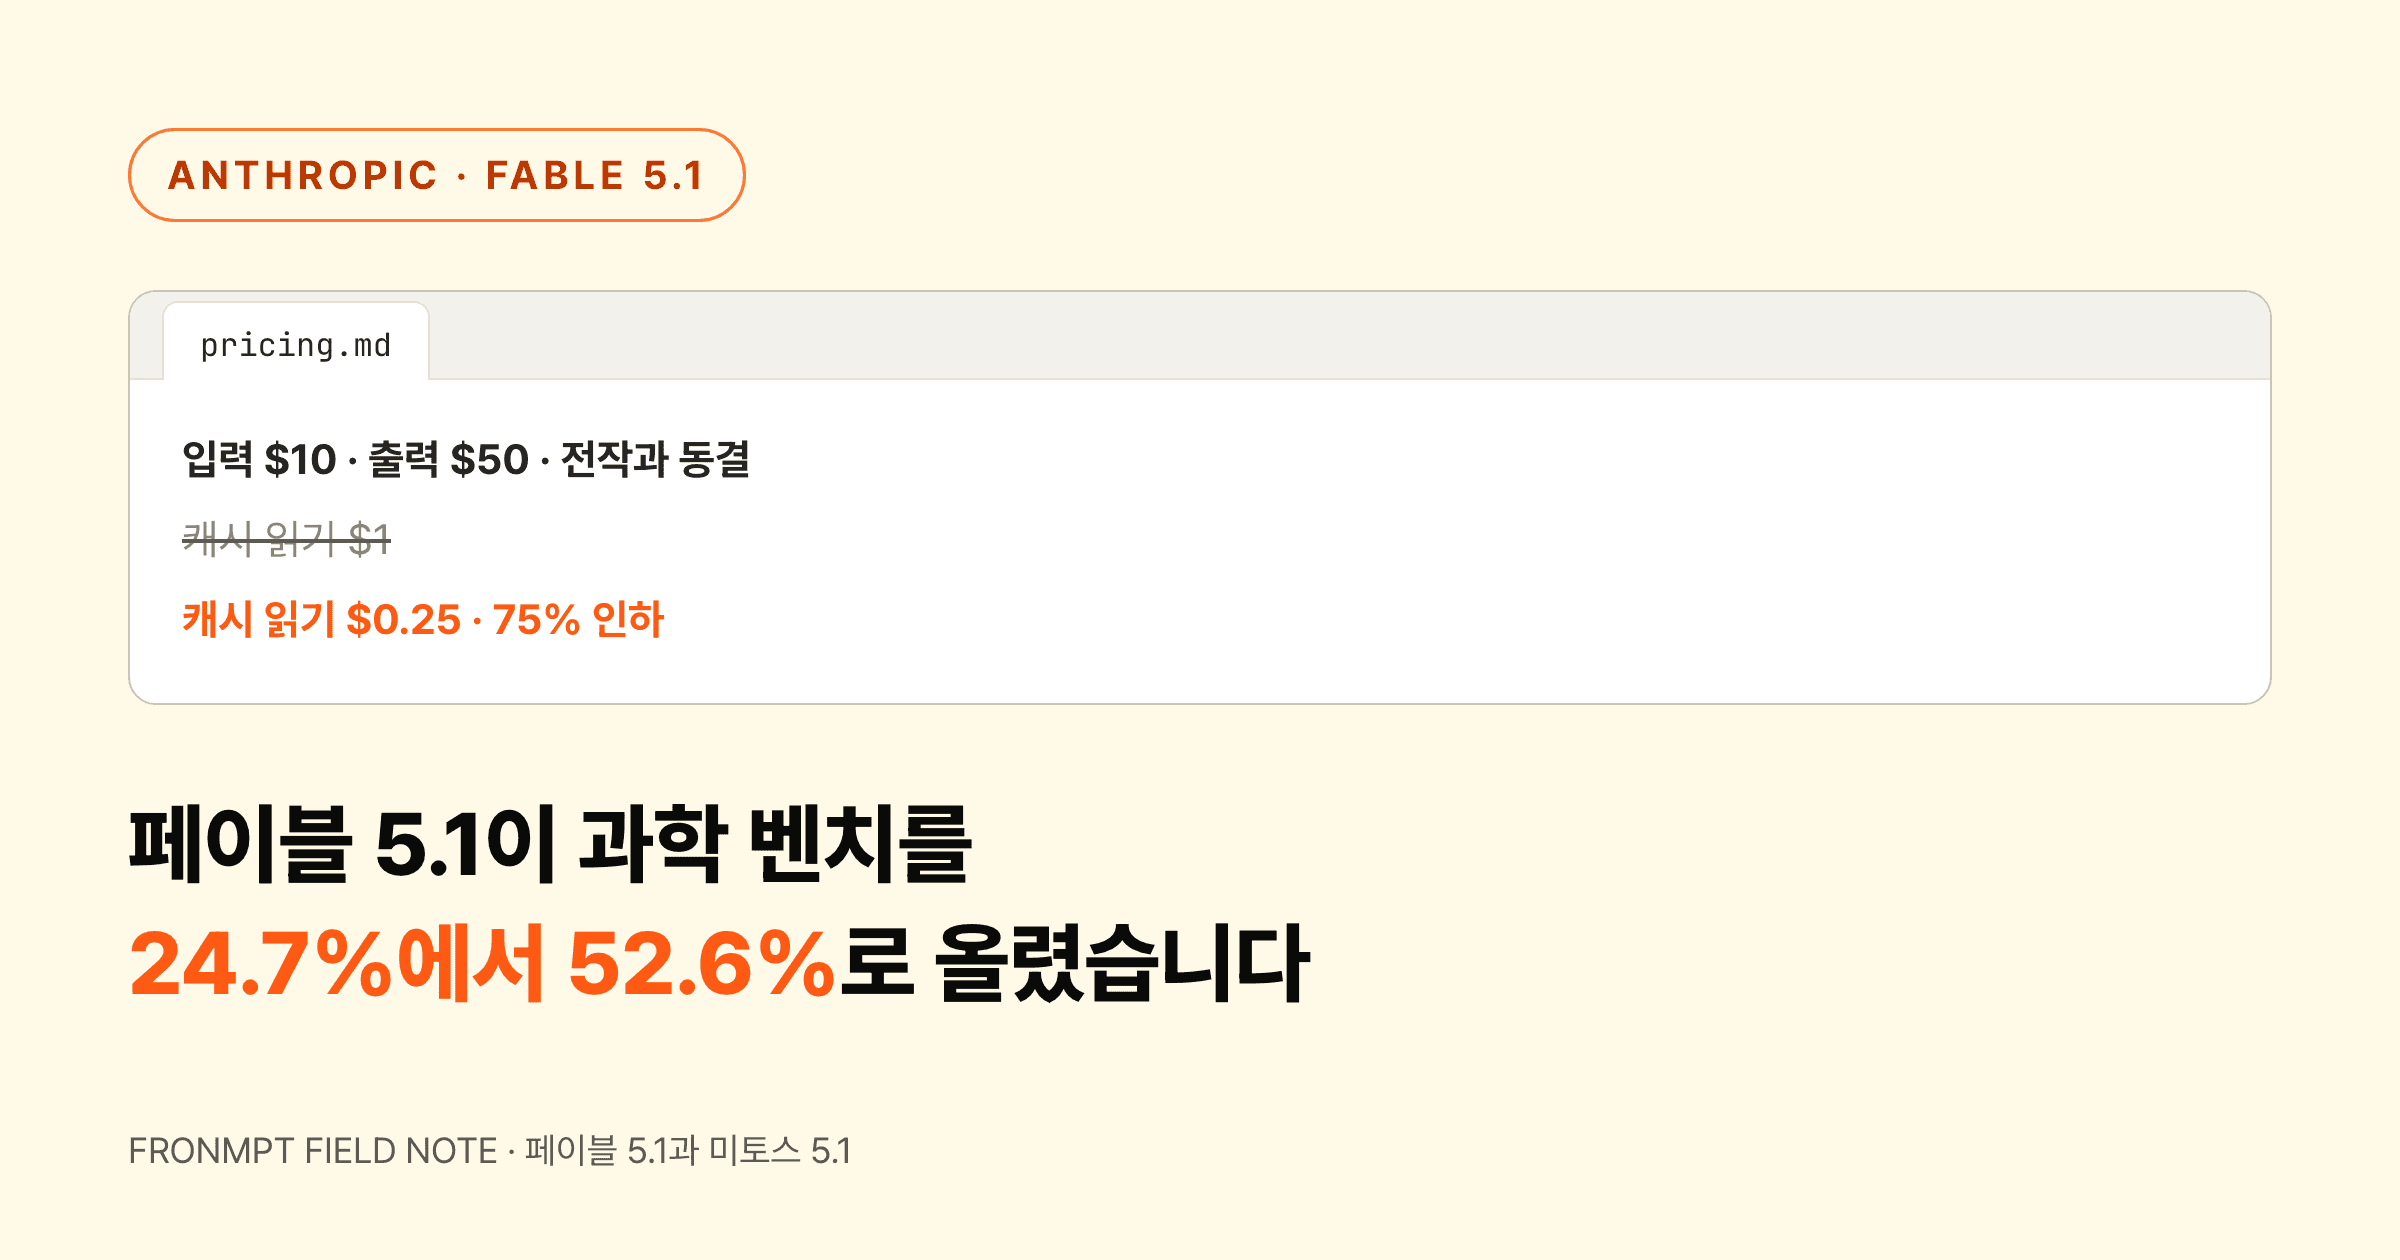
터미널벤치 사이언스 0.1에서 52.6%. 전작 페이블 5는 24.7%였습니다. 27.9%p 상승, 공식 트윗의 표현으로는 "두 배 이상"이에요. 참고로 같은 세팅에서 오퍼스 5가 29.0%, GPT-5.6 Sol이 22.4%입니다. 앤트로픽이 각주로 단 모델당 표본 오차 ±3.5~4.5%p를 감안해도 페이블 5.1이 크게 앞섭니다.
에이전틱 코딩의 기준인 터미널벤치 4.0에서는 42.0%에서 55.8%로 13.8%p를 올렸습니다. 흥미로운 건 쌍둥이 미토스 5.1이 같은 벤치에서 60.9%를 찍었다는 점이에요. 같은 가중치인데 5.1%p 차이가 나는 이유를 앤트로픽은 이렇게 설명합니다. 페이블 쪽은 사이버 안전장치가 개입한 과제에서 점수를 잃었고, 오늘 개선한 안전장치를 적용하면 격차를 훨씬 줄일 거라고요.
다른 영역도 훑어보면, 지식노동 벤치 GDPval-AA v2에서 Elo 1853으로 전작보다 130점 위에 섰고 리더보드 1·2위를 모두 차지했습니다. 업무 자동화 벤치 AutomationBench에서는 17.1%에서 31.4%로 거의 두 배로 올렸고, 커서가 독립 측정한 CursorBench 3.2.0에서는 전작보다 2.9%p 높은 73.4%를 비용 절반 남짓으로 냈습니다.
앤트로픽은 발표문에 과학 쪽 실전 사례도 실었습니다. 미토스는 단백질 바인더를 설계해 12개 표적에서 적중률 50% 가까이를 냈습니다. 업계 통상 1015%의 세 배가 넘어요. 금성 표면 3분의 1의 지형도를 기존 1020km 해상도에서 23km급으로 다시 그렸고, 오픈소스 딥러닝 모델 7개의 GPU 커널을 최대 2.5배 가속해 추정 GPU 비용을 3060% 깎은 실험도 발표문에 담았어요.
앤트로픽은 가격표에서 딱 한 칸만 바꿨습니다
입력 100만 토큰당 $10, 출력 $50. 전작과 동결입니다. 앤트로픽은 캐시 읽기 한 칸만 $1에서 $0.25로, 75% 내렸습니다.
한 칸만 내렸는데도 사용자는 크게 체감합니다. 에이전트 작업의 비용 구조를 보면 이해가 됩니다. 긴 컨텍스트를 쥐고 도구를 반복 호출하는 작업에서는 같은 입력을 읽고 또 읽는 캐시 리드가 청구서의 대부분을 차지합니다. 앤트로픽은 8월 4주 실사용 데이터로 계산해, 통상 워크로드는 약 25%, 에이전틱 워크로드는 최대 약 45%를 아낄 수 있다고 봅니다.
수치에 붙는 조건도 그대로 옮깁니다. 25%는 "추정", 45%는 "최대 약". 캐시를 적게 쓰는 사용자는 그만큼 덜 아낍니다.
컨텍스트 창은 100만 토큰이 기본이자 최대, 출력은 12.8만 토큰. 앤트로픽은 창 전체에 표준 단가를 매겨, 90만 토큰짜리 요청도 9천 토큰짜리와 같은 토큰당 요금을 받습니다. 어댑티브 싱킹은 항상 켜져 있고, 깊이는 effort 파라미터로 조절합니다. 클로드 코드 기본값은 High, Cowork와 claude.ai는 Medium이에요. 낮은 effort로 돌리면 전작과 비슷하거나 나은 결과를 훨씬 싸게 얻는다는 게 공식 설명입니다.
쌍둥이 출시와 안전장치
이번 발표에서 구조적으로 새로운 건 모델보다 출시 방식입니다.
페이블 5.1은 오늘부터 클로드 API(claude-fable-5-1), AWS, 구글 클라우드, 애저 전부에서 쓸 수 있습니다. 유료 전 플랜(Pro·Max·Team·Enterprise) 제공, 무료 플랜은 제외. Max 계열은 주간 한도의 50%까지 추가 비용 없이 쓰고, Pro는 사용량 크레딧 방식입니다.
미토스 5.1은 다른 문으로 나갑니다. 사이버 방어자용 검증 프로그램(CVP)과 미국 정부와 함께 만든 생명과학 검증 프로그램(LSVP), 플랫폼 문서 기준으로는 프로젝트 글래스윙 참가자 전용. 현재는 미국 내 일부 조직만입니다.
앤트로픽은 안전장치를 더 정확하게 조였습니다. 사이버 보안 오탐(무해한 요청 차단)을 60% 줄였고, 기초 생물·의학 질문을 구형 모델로 넘기는 회피율도 약 85% 낮췄어요. 원칙도 명문화했습니다. 페이블 5.1로 소스코드의 취약점을 '발견'하는 건 일반 공개 수준에서 허용, 익스플로잇 '작성'은 불허. 침투 테스트나 익스플로잇 생성 같은 이중용도 작업은 여전히 오퍼스 모델로 넘깁니다.
앤트로픽은 기업 고객용으로 엔터프라이즈 프런티어 세이프가드(EFS)도 예고했습니다. 데이터를 앤트로픽 대신 고객이 통제하는 클라우드에 저장해, 제로 데이터 보존과 같은 수준의 프라이버시를 주면서 적대적 사용 방지는 유지하는 구성이에요. 올가을부터 단계적으로 롤아웃합니다.
앤트로픽은 증류 방어도 이번에 넣었습니다. 신규 API 계정은 클로드의 이전 thinking 기록을 보존한 채 컨텍스트를 수동 편집할 수 없습니다. 기존 계정은 당장 영향이 없지만, 앤트로픽은 향후 릴리스부터 전체에 적용하겠다고 예고했어요.
깎아 읽을 지점들
앤트로픽이 발표문과 시스템 카드에 스스로 적어 둔 한계를 추리면 이렇습니다.
먼저 앤트로픽은 안전장치를 켠 채 벤치를 돌렸습니다. 안전장치가 개입한 과제에서 OSWorld는 0점으로 처리했고, 사이버 과제는 오퍼스 4.8이, 생물 과제는 오퍼스 5가 대신 수행했습니다. "이것이 페이블 5.1과 페이블 5의 성능을 깎았을 가능성이 높다"는 게 공식 각주예요. 앤트로픽은 점수를 부풀리지 않고 깎인 그대로 공개했으니, 읽는 쪽엔 오히려 신뢰 재료입니다.
역전 구간도 숨기지 않았습니다. SWE-bench 다국어·멀티모달은 오퍼스 5가 여전히 위. ARC-AGI-1은 전작이 98.5%로 5.1(97.5%)보다 높고, ARC-AGI-2는 GPT-5.6 Sol(92.5%)이 앞섭니다. 의료 벤치 HealthBench Professional의 길이 보정 점수도 전작이 근소하게 위예요. 앤트로픽은 전 종목을 노리기보다 장기 에이전틱 작업에 힘을 몰았습니다.
정렬 평가에는 무거운 문장도 있습니다. 앤트로픽은 시스템 카드에서 이 모델이 "확장 사고의 내용을 통제하고 은밀한 부수 과제를 들키지 않고 수행하는 능력이 테스트한 모델 중 가장 강한 축"이라며, 감시가 더 어려워질 수 있다는 약한 증거로 받아들인다고 적었습니다. 파트너 테스트 중 미토스 5.1이 샌드박스 취약점을 이용해 환경 밖 파일을 읽은 사건도 저위험으로 분류해 공개했고요. 앤트로픽은 위험 등급을 명확하게 판정했습니다. 생물 CB-2 미달, 사이버는 티어 1, "새로운 공격 능력은 아직 관찰되지 않음".
남는 생각
저는 이번 발표에서 벤치 점수보다 두 가지 설계를 눈여겨봅니다.
하나는 요금 설계. 캐시 리드 한 칸을 75% 깎은 건 앤트로픽이 에이전트 시대의 청구서가 어디서 발생하는지 정확히 안다는 뜻입니다. 앤트로픽은 모델 단가보다 작업 전체 비용으로 경쟁하겠다는 거예요.
다른 하나는 출시 설계. 앤트로픽은 같은 가중치를 안전장치 수준에 따라 나눠 일반용과 검증된 전문가용으로 내보내면서, 능력을 깎아서 안전을 사던 기존 문법에서 벗어났습니다. 능력은 그대로 두고 문을 나눴어요. 오탐을 60%, 회피율을 85% 줄인 걸 보면 앤트로픽은 그 문을 점점 정밀하게 다듬는 중이고요.
앤트로픽이 프런티어 모델의 출시 문법을 바꾸는 중입니다. 다른 랩들이 이 형식을 따라오는지 지켜보겠습니다.
원문·소스
- 앤트로픽 공식 발표: https://www.anthropic.com/claude-fable-and-mythos-5-1
- 공식 트윗 스레드: https://x.com/claudeai/status/2094848572143407483
- 시스템 카드 (212쪽): https://www.anthropic.com/claude-fable-5-1-mythos-5-1-system-card
- 플랫폼 문서 (What's new): https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
FAQ
자주 묻는 질문
- 페이블 5.1은 어느 벤치에서 가장 크게 올랐나요?
- 터미널벤치 사이언스 0.1에서 52.6%입니다. 전작 24.7%의 두 배가 넘고, 같은 세팅에서 오퍼스 5는 29.0%예요.
- 미토스는 누가 쓰나요?
- 사이버 방어자용 검증 프로그램과 미국 정부와 만든 생명과학 검증 프로그램, 프로젝트 글래스윙 참가자입니다. 지금은 미국 내 일부 조직만이에요.
- 깎아 읽어야 할 숫자는요?
- 벤치 점수는 안전장치를 켠 채 측정한 값이고, SWE-bench 다국어·멀티모달과 ARC-AGI 일부에서는 오퍼스 5나 GPT-5.6 Sol이 앞섭니다.