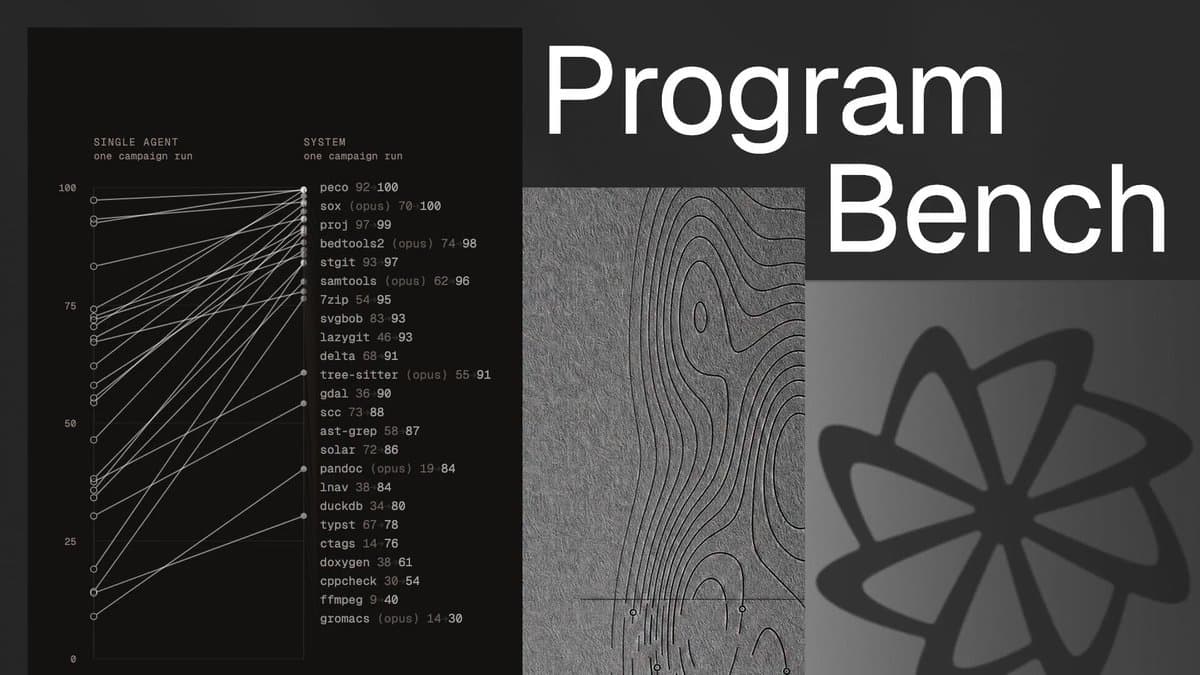
팩토리AI가 새 연구를 트윗 하나로 발표했습니다. "세계에서 가장 진보한 프로그램 역엔지니어링 시스템을 만들었다"는 문장으로 시작하는 발표예요.
팩토리AI는 트윗에 영상 하나만 달았어요.
그런데 문장을 뜯어 읽으면 조용히 넘길 내용이 아닙니다. 에이전트에게 "완료의 독립적 정의(independent definition of done)"를 줬더니, 테스트한 모든 프런티어 모델의 장기 과제 성능을 끌어올렸다는 주장이거든요.
팩토리AI가 무엇을 발표했나요?
원문을 그대로 옮기면 이렇습니다. "우리는 세계에서 가장 진보한 프로그램 역엔지니어링 시스템을 만들었다. 이 시스템은 모델 독립적이며, 에이전트에게 완료의 독립적 정의를 줌으로써 장기 소프트웨어 과제에서 우리가 테스트한 모든 프런티어 모델의 성능 개선을 보여줬다."
주장을 쪼개면 세 가지입니다.
- 프로그램을 역엔지니어링하는 시스템을 만들었다.
- 이 시스템은 특정 모델 전용이 아니다.
- 테스트한 모든 프런티어 모델에서 장기 과제 성능을 끌어올렸다.
저는 셋째를 가장 무겁게 봅니다. "일부 모델에서"도 "평균적으로"도 아니고, 테스트한 모델 전부를 개선했다는 주장이니까요.
왜 모델 불문 개선이 무거운 주장인가요?
특정 모델에서만 성능을 올렸다면, 그건 그 모델의 특성에 맞춘 튜닝 이야기입니다. 모든 모델에서 올렸다면 다르게 봐야 해요. 팩토리AI가 병목을 모델 밖에서 찾았다는 뜻이 됩니다.
팩토리AI는 그 병목으로 완료 판정을 지목했습니다. 에이전트에게 일이 끝났는지 판단할 독립적 기준이 없어서 장기 과제에서 무너진다는 진단이에요.
장기 과제일수록 이 문제는 커집니다. 단계를 길게 이어 갈수록 "여기까지 하면 된 건가"를 판단할 지점도 늘어나요. 판단 하나만 어긋나도 에이전트는 이후 작업 전체를 틀린 기준으로 진행합니다.
완료의 독립적 정의란 무엇인가요?
"독립적"이라는 단어를 저는 이렇게 읽습니다. 에이전트가 스스로 완료를 선언하게 두지 않는다는 것. 완료의 기준을 에이전트 바깥에 세워두고, 에이전트는 그 기준을 향해 일하게 한다는 것.
수험생이 자기 답안을 자기가 채점하면 점수를 후하게 줍니다. 에이전트도 같아요. 장기 과제에서 모델은 "다 된 것 같다"는 자기 판단부터 틀립니다.
여기서 팩토리AI는 역엔지니어링 시스템을 씁니다. 저는 프로그램을 역엔지니어링해 얻은 구조를 "완성이란 무엇인가"의 독립적 기준으로 삼는 구도로 읽어요. 다만 팩토리AI가 원문 트윗에서 시스템 내부를 공개하지는 않아서, 구체 구현은 후속 자료로 확인해야 합니다.
원문보다 인용이 왜 더 멀리 갔나요?
이 발표를 인용하며 X 아티클을 단 글은 조회 10만을 넘겼어요. 원문 트윗보다 훨씬 많은 사람이 봤습니다.
사람들이 발표문 자체보다 풀이 쪽으로 몰렸다는 뜻이고, 저는 이 연구가 해설을 부르는 주제라고 봅니다. 인용 글의 전문은 아직 확보하지 못했습니다. 여기에는 조회수까지만 적었어요.
남는 생각
저는 이 발표를 검증 루프 연구의 공식화로 읽습니다.
제가 계속 추적해온 축이 있습니다. 에이전트는 일을 끝냈는지 판정하는 단계에서 무너진다는 것. 검증 루프를 세우고 승인선을 긋는 쪽이 결과물을 가져간다는 것.
현장에서 경험칙으로 굴러다니던 이 이야기를, 팩토리AI는 "테스트한 모든 프런티어 모델에서 개선"이라는 실험 결과로 내놨습니다. 팩토리AI가 경험칙을 연구로 만든 거예요.
저는 에이전트를 만드는 팀들이 다음에 여기서 경쟁할 거라고 봅니다. 모델은 갈아 끼우면 됩니다. 모델 불문이니까요. 완료를 정의하는 체계는 갈아 끼울 수 없습니다. 저는 에이전트 시대의 해자를 이 완료 판정 체계에서 찾습니다.
원문·소스
- 팩토리AI 연구 발표 트윗 (@FactoryAI): https://x.com/FactoryAI/status/2093077744292884896 (조회 6만 6천, 좋아요 671, 리트윗 59)
FAQ
자주 묻는 질문
- 팩토리AI가 무엇을 발표했나요?
- 세계에서 가장 진보한 프로그램 역엔지니어링 시스템을 만들었다는 연구 발표입니다. 팩토리AI는 이 시스템이 모델 독립적이며, 에이전트에게 완료의 독립적 정의를 줘서 테스트한 모든 프런티어 모델의 장기 과제 성능을 끌어올렸다고 주장합니다.
- 왜 모델 불문 개선이 무거운 주장인가요?
- 팩토리AI가 특정 모델 하나만 끌어올렸다면 그 모델에 맞춘 튜닝 이야기로 끝납니다. 모든 모델을 끌어올렸다면 병목은 모델 밖에 있었다고 봐야죠. 팩토리AI는 그 병목으로 완료 판정을 지목했습니다.
- 완료의 독립적 정의란 무엇인가요?
- 에이전트가 스스로 완료를 선언하게 두지 않고, 완료의 기준을 에이전트 바깥에 세워두는 것입니다. 팩토리AI는 프로그램을 역엔지니어링해 얻은 구조를 그 독립적 기준으로 삼는 것으로 보입니다.
- 왜 사람들은 원문보다 인용 글을 더 널리 공유했나요?
- 사람들은 이 발표를 인용하며 X 아티클을 단 글을 원문 트윗보다 더 널리 공유했습니다. 발표문 자체보다 풀이 쪽으로 사람이 몰렸다는 뜻이고, 이 연구가 해설을 부르는 주제라는 방증입니다.
SEASON 3
시즌3 「콘텐츠로 팔기」
AI와 콘텐츠를 만들고 고객에게 연결하는 4주
제가 에이전트로 조사하고 쓰고 파는 과정을 그대로 보여 드려요. 그다음 각자의 주제로 같이 만들어 봐요.
10월 2일 OT · 10월 5일부터 월·수 4주 · 10월 31일 오프라인
시즌3 커리큘럼 보기