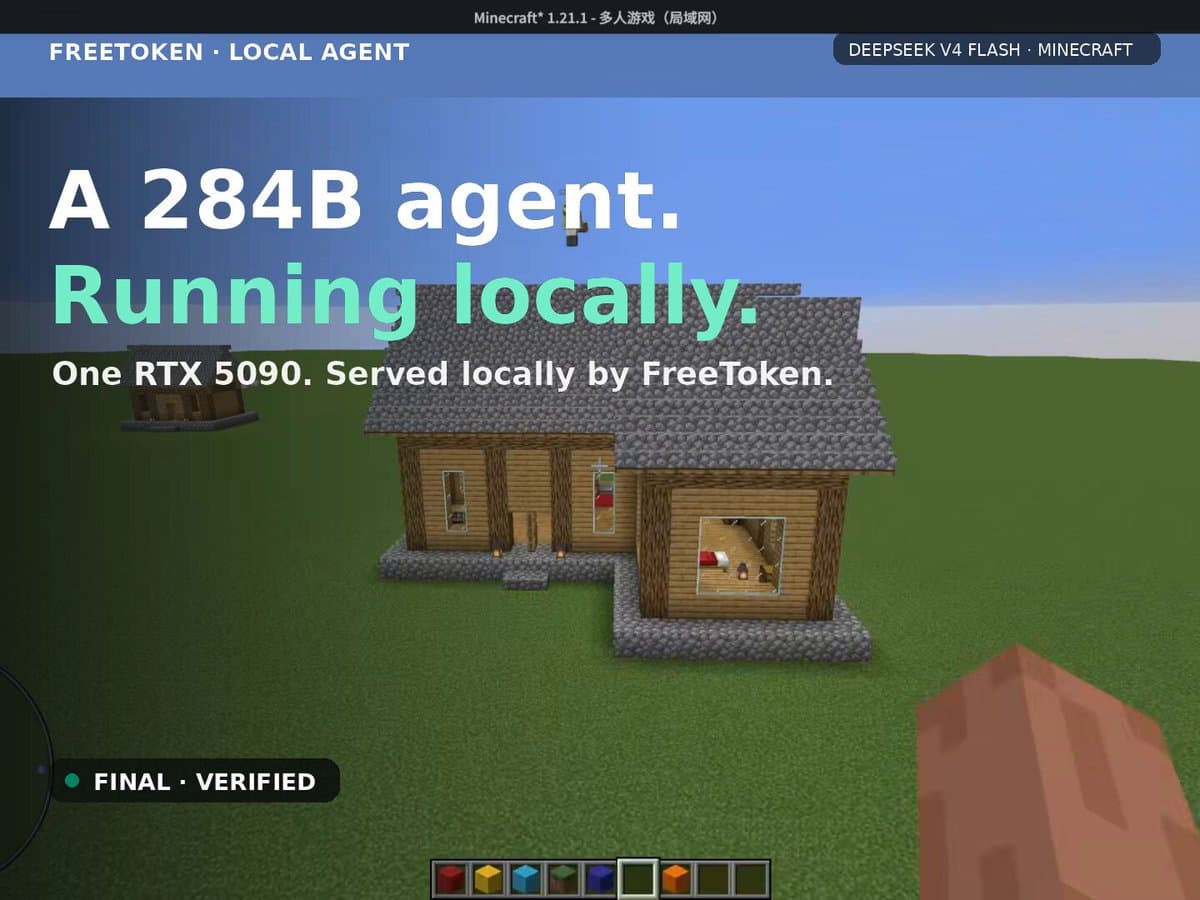
8GB RTX 4060 노트북에서 크웬3.6 35B가 초당 39토큰으로 돕니다. RTX 5090 데스크톱에서는 284B 딥시크 V4-Flash가 초당 22~25토큰, RTX PRO 6000 워크스테이션에서는 753B GLM-5.2가 초당 15토큰이에요.
연구진은 극단 양자화 없이 공식 체크포인트 그대로 이 속도를 냈습니다.
사람들은 8월 21일 올라온 발표 트윗을 1,063,851번 봤고, 좋아요보다 북마크를 더 많이 눌렀습니다. 직접 장비에 깔아 보려는 사람이 많았다는 뜻이에요.
연구진은 실제 구동 장면을 담은 데모 영상과 함께 발표 문구를 이렇게 끝맺었습니다. "클로드 코드든 코덱스든, 이제 프론티어 모델로 0달러에 돌리세요." 버클리 연구진이 공개한 오픈소스 추론 엔진, FreeToken 이야기입니다.
FreeToken은 어떻게 게이밍 PC에서 프론티어 모델을 돌리나요?
연구진은 반대 방향으로 접근했습니다.
지금까지 사람들은 모델을 깎아서 우겨넣는 방식으로 로컬에서 돌렸어요. 4비트로 누르고, 성능 저하를 감수하고, "그래도 로컬이니까"로 위안하는 구조였습니다. 그 대가로 공식 체크포인트와는 다른 물건을 돌리게 되고요.
FreeToken은 모델 대신 하드웨어를 쥐어짭니다. GPU, CPU, 램, 인터커넥트를 하나의 탄력적 추론 플랫폼으로 묶어서, 게이밍 PC 한 대가 가진 자원을 남김없이 긁어 쓰는 쪽이에요.
FreeToken은 MoE 구조 덕에 이렇게 할 수 있습니다. 혼합전문가 모델은 추론 때 전문가 일부만 켜지는데, FreeToken은 대역폭에 맞춰 전문가를 CPU와 GPU에 동적으로 배분하고, 자주 쓰는 전문가만 VRAM에 캐시합니다. FreeToken은 이 방식으로 753B 모델을 GPU 한 장에서 돌립니다.
저자가 후속 트윗에서 방법론을 두 구절로 요약했습니다. "대역폭 적응형 CPU-GPU 실행, 그리고 시맨틱 인지 캐싱." 근거로 아카이브 논문도 걸어뒀고요.
올라마보다 얼마나 빠른가요?
저자는 속도도 구체적으로 주장합니다.
같은 후속 트윗에서 로컬 실행의 사실상 표준인 올라마와 비교해 디코드 34배, 프리필 630배 빠르다고 밝혔어요.
특히 프리필에서 크게 앞섰어요. 프리필은 긴 컨텍스트를 읽어들이는 단계라, 코드베이스를 통째로 물고 시작하는 코딩 에이전트 워크로드에서 병목이 되는 구간이거든요.
연구진은 에이전트 작업을 위한 장치도 따로 넣었습니다. 툴 호출이나 사고 블록으로 컨텍스트가 수정돼도 재계산을 피하는 시맨틱 앵커 체크포인트예요. 연구진은 처음부터 클로드 코드·코덱스 같은 코딩 에이전트를 겨냥해 설계했어요.
누가 만들었고 어떻게 설치하나요?
Song Han, Ion Stoica, Matei Zaharia, Kurt Keutzer. 효율 추론과 분산 시스템의 교과서급 이름들이 저자 명단에 올라 있습니다. 익명 레포의 과장 벤치마크로 치부하기 어려운 라인업이에요.
연구진은 배포도 진입장벽을 낮추는 쪽으로 했습니다. 아파치 2.0 오픈소스에, 앤트로픽·오픈AI 호환 API라 기존 코딩 에이전트에 바로 연결할 수 있어요. 네이티브 GUI와 한 줄 설치까지 제품처럼 갖췄습니다.
답글을 보면 사람들이 뭘 원하는지 알 수 있어요. 맥 지원을 묻는 답글에는 "가는 중"이라고 답했고, 사람들은 듀얼 GPU 구성, 안드로이드, VS Code 연동, 윈도우 설치 폴더, 아치 리눅스 설치 깨짐까지 질문을 쏟아냈어요. 다들 지금 당장 자기 장비에 깔아 보려고 묻는 거예요.
모델과 엔진은 어느 방향으로 움직이나요?
닷새 뒤 크웬이 낸 Flash-Next와 함께 보면 흐름을 알 수 있어요.
크웬의 새 모델은 활성 파라미터가 6B예요. 모델을 만드는 회사들은 추론 때 켜지는 부분을 줄이고 있고, FreeToken 같은 엔진은 소비자 GPU로 내려오고 있습니다. 양쪽이 같은 지점을 향해 움직이는 거예요.
모델 회사들이 MoE의 활성 파라미터를 줄일수록, 전문가를 CPU와 GPU에 나눠 태우는 FreeToken은 더 큰 이득을 봅니다.
남는 생각
저는 FreeToken이 셀프호스트의 임계점을 넘었다고 봅니다.
어제까지 로컬에서 프론티어 모델을 돌리려면 다중 GPU 서버가 필요했어요. 이제는 게이밍 PC와 전기요금이면 됩니다. "내 장비로는 못 돌린다"며 구독료를 내던 사람들도 이제 다른 선택지를 갖게 됐어요.
저는 토큰 비용 구조를 다시 짤 때가 됐다는 신호로도 봅니다. API는 쓴 만큼 무한히 늘어나는 변동비로 과금하고, 로컬에서는 이미 산 GPU에 전기요금만 더 내는 고정비로 돌리거든요. 에이전트를 24시간 돌릴수록 로컬로 돌리는 사람이 더 유리해집니다.
다만 초기 버전 특유의 거칢은 감안해야 합니다. 답글창의 설치 깨짐 보고를 보면, 연구진은 아직 지원 포맷과 설정을 넓게 다듬지 못했어요. 맥 사용자는 기다려야 하고, 리눅스 배포판에 따라 설치가 깨지기도 합니다.
그래도 저는 이 방향이 맞다고 봅니다. 교과서급 저자들이 아파치 라이선스로 문을 열었고, 발표를 본 사람들은 감상 대신 저장을 택했어요.
원문·소스
- FreeToken 발표 트윗 (@Andy_ShuoYang): https://x.com/Andy_ShuoYang/status/2090856976880472439 (조회 1,063,851, 좋아요 3,800, 리트윗 509, 답글 254개, 인용 189건, 북마크 4,493, 2026-08-21)
- 올라마 대비 성능 비교 후속 트윗: https://x.com/Andy_ShuoYang/status/2090856978428145761 (조회 457,079, 좋아요 2,571)
- 논문: https://arxiv.org/abs/2608.16157
- 깃허브 레포: https://github.com/FlashML-org/FreeToken
- 다운로드: https://flashml.ai
FAQ
자주 묻는 질문
- FreeToken은 어떻게 게이밍 PC에서 프론티어 모델을 돌리나요?
- 모델을 4비트로 깎는 대신 GPU, CPU, 램, 인터커넥트를 하나의 탄력적 추론 플랫폼으로 묶습니다. MoE 전문가를 대역폭에 맞춰 CPU와 GPU에 동적으로 배분하고 자주 쓰는 전문가만 VRAM에 캐시해, 753B 모델도 GPU 한 장에서 돌려요.
- 올라마보다 얼마나 빠른가요?
- 저자가 후속 트윗에서 디코드 3~4배, 프리필 6~30배 빠르다고 밝혔습니다. 프리필은 코드베이스를 통째로 읽어들이는 코딩 에이전트 워크로드의 병목 구간이라, 코딩 에이전트를 돌리는 사람은 이 차이를 바로 체감합니다.
- 누가 만들었고 어떻게 설치하나요?
- Song Han, Ion Stoica, Matei Zaharia, Kurt Keutzer가 저자 명단에 오른 버클리 연구진의 물건입니다. 아파치 2.0 오픈소스에 앤트로픽·오픈AI 호환 API, 네이티브 GUI, 한 줄 설치까지 갖췄습니다.
- 모델과 엔진 개발자들은 어느 쪽으로 가고 있나요?
- 닷새 뒤 크웬이 낸 Flash-Next는 활성 파라미터가 6B입니다. 모델 개발사는 추론 때 켜지는 부분을 줄이고, 엔진 개발자는 소비자 GPU에서 돌리는 쪽으로 내려오고 있어요. 두 진영이 같은 지점으로 가는 중입니다.
SEASON 3
시즌3 「콘텐츠로 팔기」
AI와 콘텐츠를 만들고 고객에게 연결하는 4주
제가 에이전트로 조사하고 쓰고 파는 과정을 그대로 보여 드려요. 그다음 각자의 주제로 같이 만들어 봐요.
10월 2일 OT · 10월 5일부터 월·수 4주 · 10월 31일 오프라인
시즌3 커리큘럼 보기