시청자가 채팅창에 한 줄을 칩니다. 몇 초 뒤, AI가 그 말대로 다음 장면을 이어 갑니다. AI는 방금 올라온 문장을 다음 클립 줄거리로 씁니다.
fal이 이 구조를 통째로 오픈소스로 풀었습니다. 무한히 돌아가는 AI 방송을 만드는 코드입니다. 사람들은 공개 글에 북마크를 810건 남겼어요.
fal은 영상 생성 속도를 재생 속도보다 빠르게 끌어올렸습니다. 저는 이번 공개에서 화질이나 연출보다 이 속도를 봤습니다.
방송이 왜 끊기지 않을까요?
산수 하나로 설명할 수 있습니다.
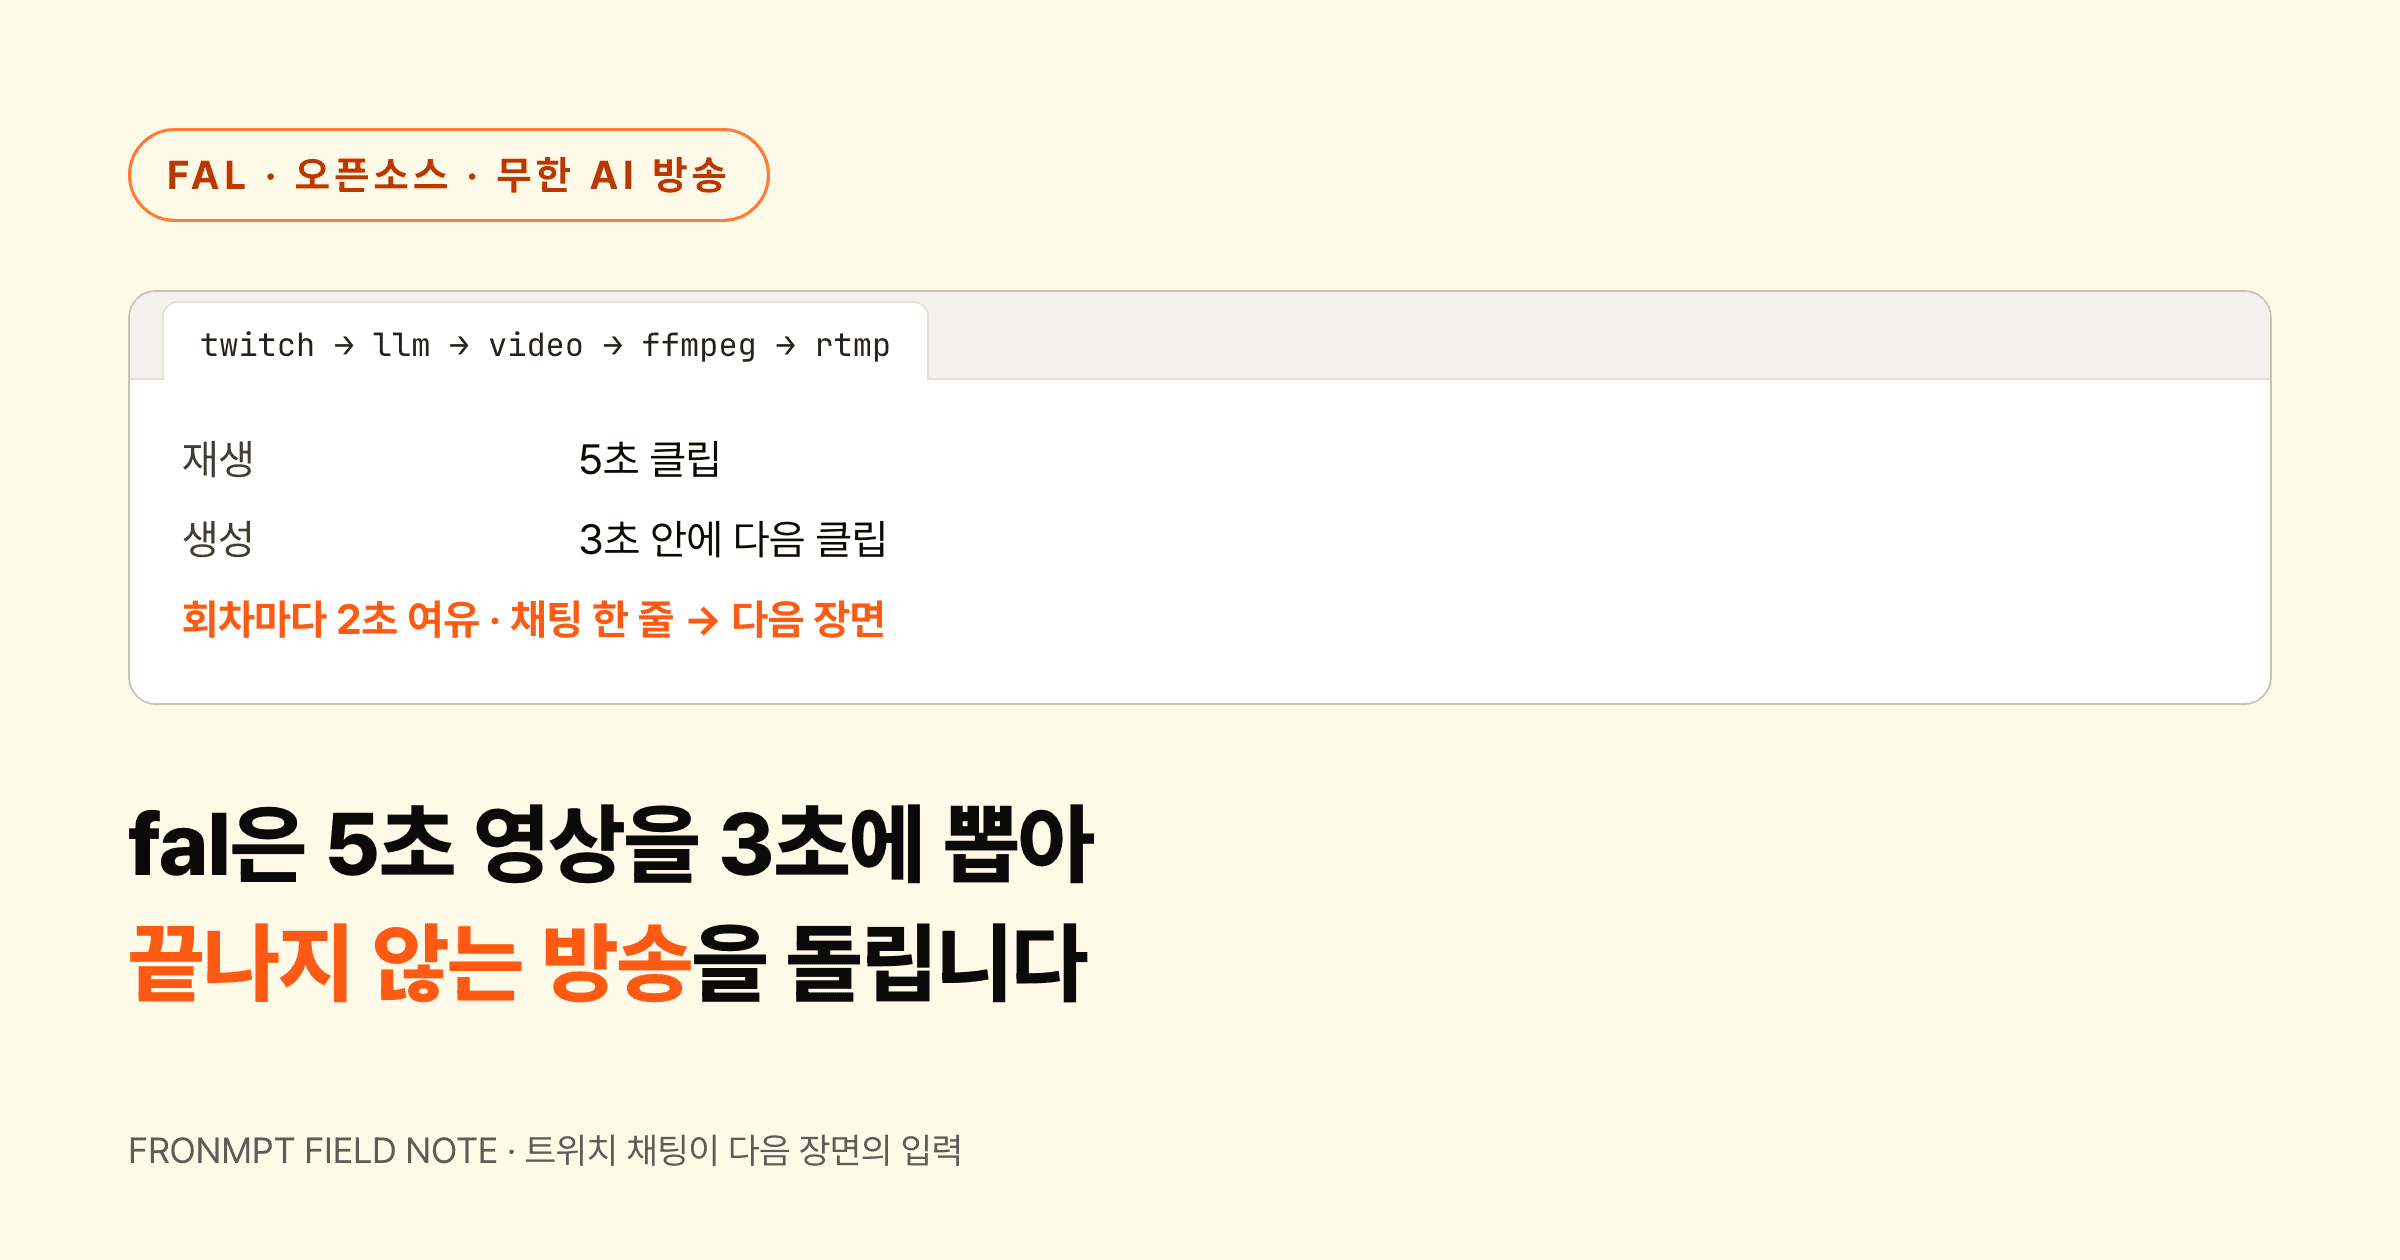
fal이 미니맥스 H3 Max를 가져다 추가 학습과 추론 최적화를 다시 걸었습니다. 이 가속판은 5초짜리 영상을 3초 안에 뽑아냅니다. 15초짜리는 9초쯤에 뽑고요. 공식판보다 열 배 많이 처리합니다.
숫자를 나란히 놓아 봅니다. 화면에서 5초짜리 클립을 재생하는 동안, 모델은 다음 5초짜리 클립을 3초 만에 만듭니다. 한 회차 돌 때마다 2초씩 여유를 버는 셈이에요. 이 여유를 계속 확보하면 재생 대기열을 비울 일이 없습니다.
운영자는 대개 다음 소스가 늦게 도착할 때 방송 사고를 겪습니다. 생성을 재생보다 빠르게 돌리면 그 사고를 구조적으로 막을 수 있어요. 그래서 이 방송에는 끝이 없습니다. 사람이 끄기 전까지 계속 돕니다.
여기서는 한 자릿수 배수 차이로 운영자가 전혀 다른 물건을 얻습니다. 열 배 느린 모델로 같은 코드를 돌리면 5초 클립을 만드는 데 30초가 걸려요. 그러면 시청자는 25초씩 멈춘 화면을 봅니다. 같은 파이프라인을 쓰고도 느린 쪽은 로딩 화면만 내보내는 셈이죠.
두 숫자를 나눠 보면 같은 비율을 얻습니다. 5초를 3초에, 15초를 9초에. 모델은 둘 다 실제 재생 시간보다 1.6배 넘게 빨리 만듭니다. 클립을 길게 잡아도 여유 폭 비율을 그대로 유지할 수 있다는 뜻이에요.
운영자는 여기서 손잡이 하나를 얻습니다. 클립을 짧게 끊으면 채팅을 화면에 더 빨리 반영할 수 있어요. 대신 확보하는 여유도 같이 줄어서, 서버가 잠깐 밀리면 시청자가 바로 알아챕니다. 길게 끊으면 여유를 더 벌지만 시청자는 자기가 친 말이 화면에 뜰 때까지 더 기다려야 합니다. 5초 클립이면 다음 장면까지 최대 5초, 15초 클립이면 최대 15초예요. 운영자는 여기서 반응 속도와 안정성을 맞바꿉니다.
이 방송은 어떻게 돌아갈까요?
fal의 코드는 모듈 다섯 개를 루프로 돌립니다.
첫째, 트위치 채팅을 받습니다. 중국어권에서 탄막이라 부르는 그 흐르는 글자들을 입력으로 씁니다.
둘째, LLM이 그 말을 읽고 다음 장면 프롬프트로 고쳐 씁니다. 시청자 문장을 영상 모델용 지시문으로 옮기는 단계예요.
셋째, fal 위에 올라간 영상 모델이 몇 초짜리 클립을 새로 뽑습니다.
넷째, FFmpeg이 나온 클립을 앞 영상에 이어붙이고 RTMP로 트위치에 쏩니다.
다섯째를 저는 이 설계에서 제일 중요하게 봅니다. 코드는 지금 클립을 트는 동안 다음 클립을 미리 만들어 둡니다. 재생과 생성을 겹쳐 돌리는 겁니다.
부품만 보면 전부 흔합니다. 채팅 API, LLM 호출, 영상 모델, FFmpeg, RTMP 송출. 새 기술은 하나도 없어요. fal은 순서를 이렇게 겹쳐 놓고 앞단 속도를 밀어 올렸을 뿐입니다. 그래서 이 레포는 배관 도면에 가깝습니다.
왜 이 순서가 처음일까요?
지금까지 사람들은 AI 영상을 만들어 두고 나중에 올렸습니다. 프롬프트를 넣고, 결과를 받고, 마음에 들면 편집해서 게시합니다. 만드는 사람과 보는 사람은 늘 다른 시점에 영상을 만났어요.
fal은 이 방송으로 그 간격을 없앴습니다. AI 영상을 선제작 후 발행하는 틀에서 꺼내 실시간 방송 스트림에 바로 넣었습니다.
시청자가 하는 일도 같이 바뀝니다. 기존 방송에서 시청자는 정해진 화면을 보며 채팅으로 반응했어요. 여기서는 시청자가 채팅으로 다음 장면을 입력합니다. 한마디 칠 때마다 다음 장면 줄거리를 바꿀 수 있어요.
콘텐츠를 보는 사람과 만드는 사람이 같은 순간에 겹치는 구조입니다. 저는 이게 이번 공개에서 제일 큰 대목이라고 봅니다. 속도는 언젠가 누구나 따라잡지만, 시청자를 생산 라인 안에 넣은 배치는 따라 하기 어렵거든요.
벌써 실제로 돌리는 사람도 있습니다. @rehan_shei는 이 가속판을 방송에 직결해 멈추지 않는 방송국을 세웠어요. 지금도 계속 켜져 있는 채널입니다.
그럼 아직 뭐가 안 될까요?
한계도 있습니다.
이 방송은 몇 초짜리 클립을 계속 이어붙이는 방식이라, 프레임 단위로 실시간 생성하지는 않습니다. 모델이 클립과 클립 사이에서 인물을 바꾸거나 배경을 튀게 만들 수 있어요. 게임 화면처럼 매끈하게 흐르는 그림을 기대하면 실망합니다.
운영자가 연출을 얼마나 통제할지도 미지수입니다. 시청자 채팅을 프롬프트로 넣으면 아무나 방송 줄거리를 흔들 수 있어요. 운영자는 즉흥극의 재미와 함께 사고 위험도 떠안습니다.
화질도 마찬가지입니다. 속도를 위해 최적화한 모델이 얼마나 버텨주는지는 아직 아무도 길게 검증하지 않았어요. 몇 주씩 돌리는 운영자는 몇 시간 돌린 사람과 다른 문제를 만납니다.
공개 글에서 저는 비용 얘기를 찾지 못했어요. 끊김 없이 돌리려면 영상 모델을 24시간 쉬지 않고 호출해야 해요. 시청자가 한 명이든 천 명이든 GPU는 똑같이 돕니다. 무한 방송 비용은 결국 운영자가 GPU 고지서로 냅니다.
저는 이 공개를 어떻게 읽을까요?
저는 이 물건이 방송보다 게임에 가깝다고 읽습니다.
게임에서는 플레이어가 입력하고 화면이 반응합니다. 시청자가 채팅 한 줄로 다음 장면을 바꾸는 순간, 이 채널도 게임 쪽으로 넘어갑니다. 운영자는 시청 시간보다 참여 횟수를 보게 됩니다.
fal은 코드를 통째로 깃허브에 올렸어요. 회사 데모로 끝나지 않고, GPU 값만 감당할 수 있으면 누구나 자기 채널을 세울 수 있습니다. 기술 장벽을 넘으면 운영자는 다른 문제를 만납니다. 무엇을 틀 것인가, 채팅을 어디까지 받아줄 것인가. 이제 운영자는 편성으로 승부합니다.
저는 생성 속도가 재생 속도를 넘어선 뒤로, 사람들이 콘텐츠를 완성본으로 받지 않게 됐다고 봅니다.
원문·소스
- 생성이 재생을 추월했다 (@HoodyLiu): https://x.com/HoodyLiu/status/2093967959723065743
- fal 무한 AI 방송 오픈소스 해설 (@HoodyLiu): https://x.com/HoodyLiu/status/2093912275203854440
- infinite-tv 레포: https://github.com/alex-remade/infinte-tv
FAQ
자주 묻는 질문
- 방송이 왜 끊기지 않을까요?
- 5초짜리 영상을 3초 안에 뽑아내서, 한 회차마다 2초씩 여유를 법니다. 생성이 재생보다 빠른 동안에는 재생 대기열이 비지 않아요. 다음 소스가 늦게 도착하는 사고를 구조로 막는 셈입니다.
- 이 방송은 어떻게 돌아갈까요?
- 트위치 채팅을 받고, LLM이 장면 프롬프트로 고쳐 쓰고, 영상 모델이 클립을 뽑고, FFmpeg이 RTMP로 송출하는 다섯 단계 루프입니다. 지금 클립을 트는 동안 다음 클립을 미리 만들어, 재생과 생성을 겹쳐 돌립니다. 부품은 전부 흔하지만 순서를 겹쳐 놓고 앞단 속도를 밀어 올린 게 핵심이에요.
- 이런 방송은 왜 전에 없었을까요?
- 지금까지 AI 영상은 만들어 두고 나중에 올리는 물건이었습니다. 이 방송은 만드는 시점과 보는 시점 사이 간격을 없앴어요. 채팅이 입력이 되면서 시청자가 생산 라인 안에 들어간 구조입니다.
- 그럼 아직 뭐가 안 될까요?
- 클립과 클립 사이에서 인물이 달라지거나 배경이 튈 여지가 남아 있습니다. 시청자 채팅이 프롬프트로 들어가므로 연출 통제가 어렵고, 24시간 영상 모델을 호출하는 비용도 빠져 있어요. 속도를 위해 최적화한 모델의 화질이 장시간 버텨주는지도 아직 검증되지 않았습니다.
SEASON 3
시즌3 「콘텐츠로 팔기」
AI와 콘텐츠를 만들고 고객에게 연결하는 4주
제가 에이전트로 조사하고 쓰고 파는 과정을 그대로 보여 드려요. 그다음 각자의 주제로 같이 만들어 봐요.
10월 2일 OT · 10월 5일부터 월·수 4주 · 10월 31일 오프라인
시즌3 커리큘럼 보기