
기존 AI보다 193배 빠르고 444배 싸다는 모델을 TypeSafe AI가 내놨습니다.
이름은 Jev입니다. Jev는 글을 한 글자도 쓰지 않고 판단만 해요.
ChatGPT나 Claude는 답을 한 조각(토큰)씩 이어 씁니다. 한 조각을 쓸 때마다 모델 전체를 한 바퀴 돌리죠. 100조각짜리 답이면 모델을 100번 넘게 돌립니다. 사용자는 대부분 이 반복 때문에 응답을 기다리고 요금을 냅니다.
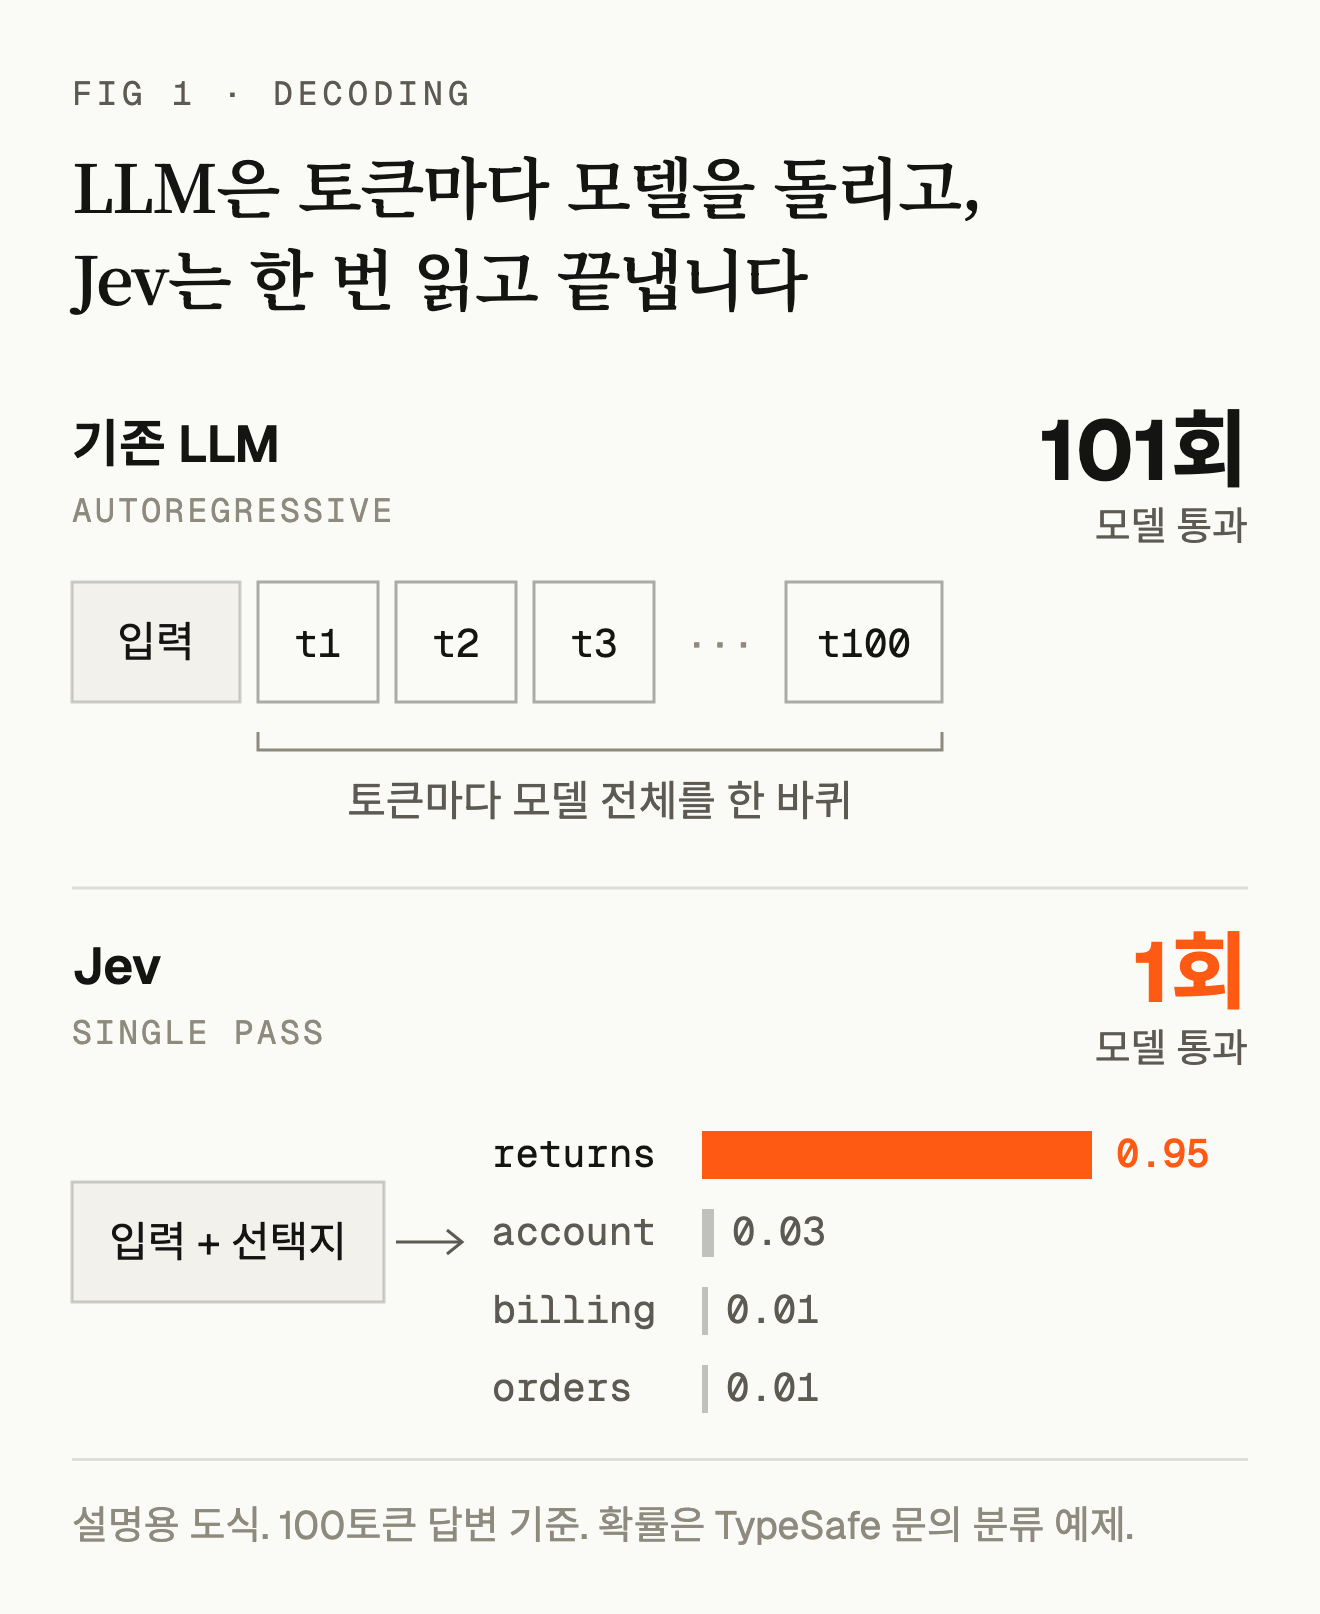
Jev는 이 반복을 통째로 뺐습니다. 입력을 한 번 읽고, 미리 정한 선택지마다 확률을 매겨 돌려줘요. 글자를 쓰지 않으니 TypeSafe는 출력 요금도 받지 않습니다.
벌써 여러 회사가 Jev를 씁니다. Vercel은 사내 분류 작업을 Jev로 바꿔 속도를 6배 높였어요. Browser Use는 Jev로 아주 빠른 브라우저 에이전트를 만들어 공개했고요.
개발자들이 먼저 만든 사례를 보면 공통점이 하나 있습니다.
- 항공권 검색. 취리히발 런던행 표를 7.1초 만에 찾았습니다.
- 논문 선별. 1,018편을 한 편씩 판정하고 8센트를 썼어요.
- 맥 화면 조작. 다음 동작 하나를 고르는 데 0.0002달러를 씁니다.
- 드론 제어. 1초에 두어 번 갈 방향을 정합니다.
네 곳 모두 Jev에게 글을 시키지 않았습니다. 고르고 판정하는 일만 맡겼어요. TypeSafe도 193배, 444배를 이런 판단 작업으로 측정했습니다.
저도 Jev로 제 작업 도구 두 개를 실제로 만들어 봤습니다. 한 곳에서는 모델 호출을 20분의 1로 줄였고, 다른 곳에서는 1.8초 손해를 봤어요.
| 제 작업 | 결과 |
|---|---|
| 블로그 카피 톤 검사기 | 모델 호출 20분의 1 |
| 뉴스 고르는 에이전트 | 처리 시간 1.8초 손해 |
저는 작업 구조에서 이유를 찾았어요. 독립 측정과 제 실측을 겹쳐 놓고 어디서부터 이득인지 따져 봤습니다.
193배는 비교 방식에서 나온 숫자입니다
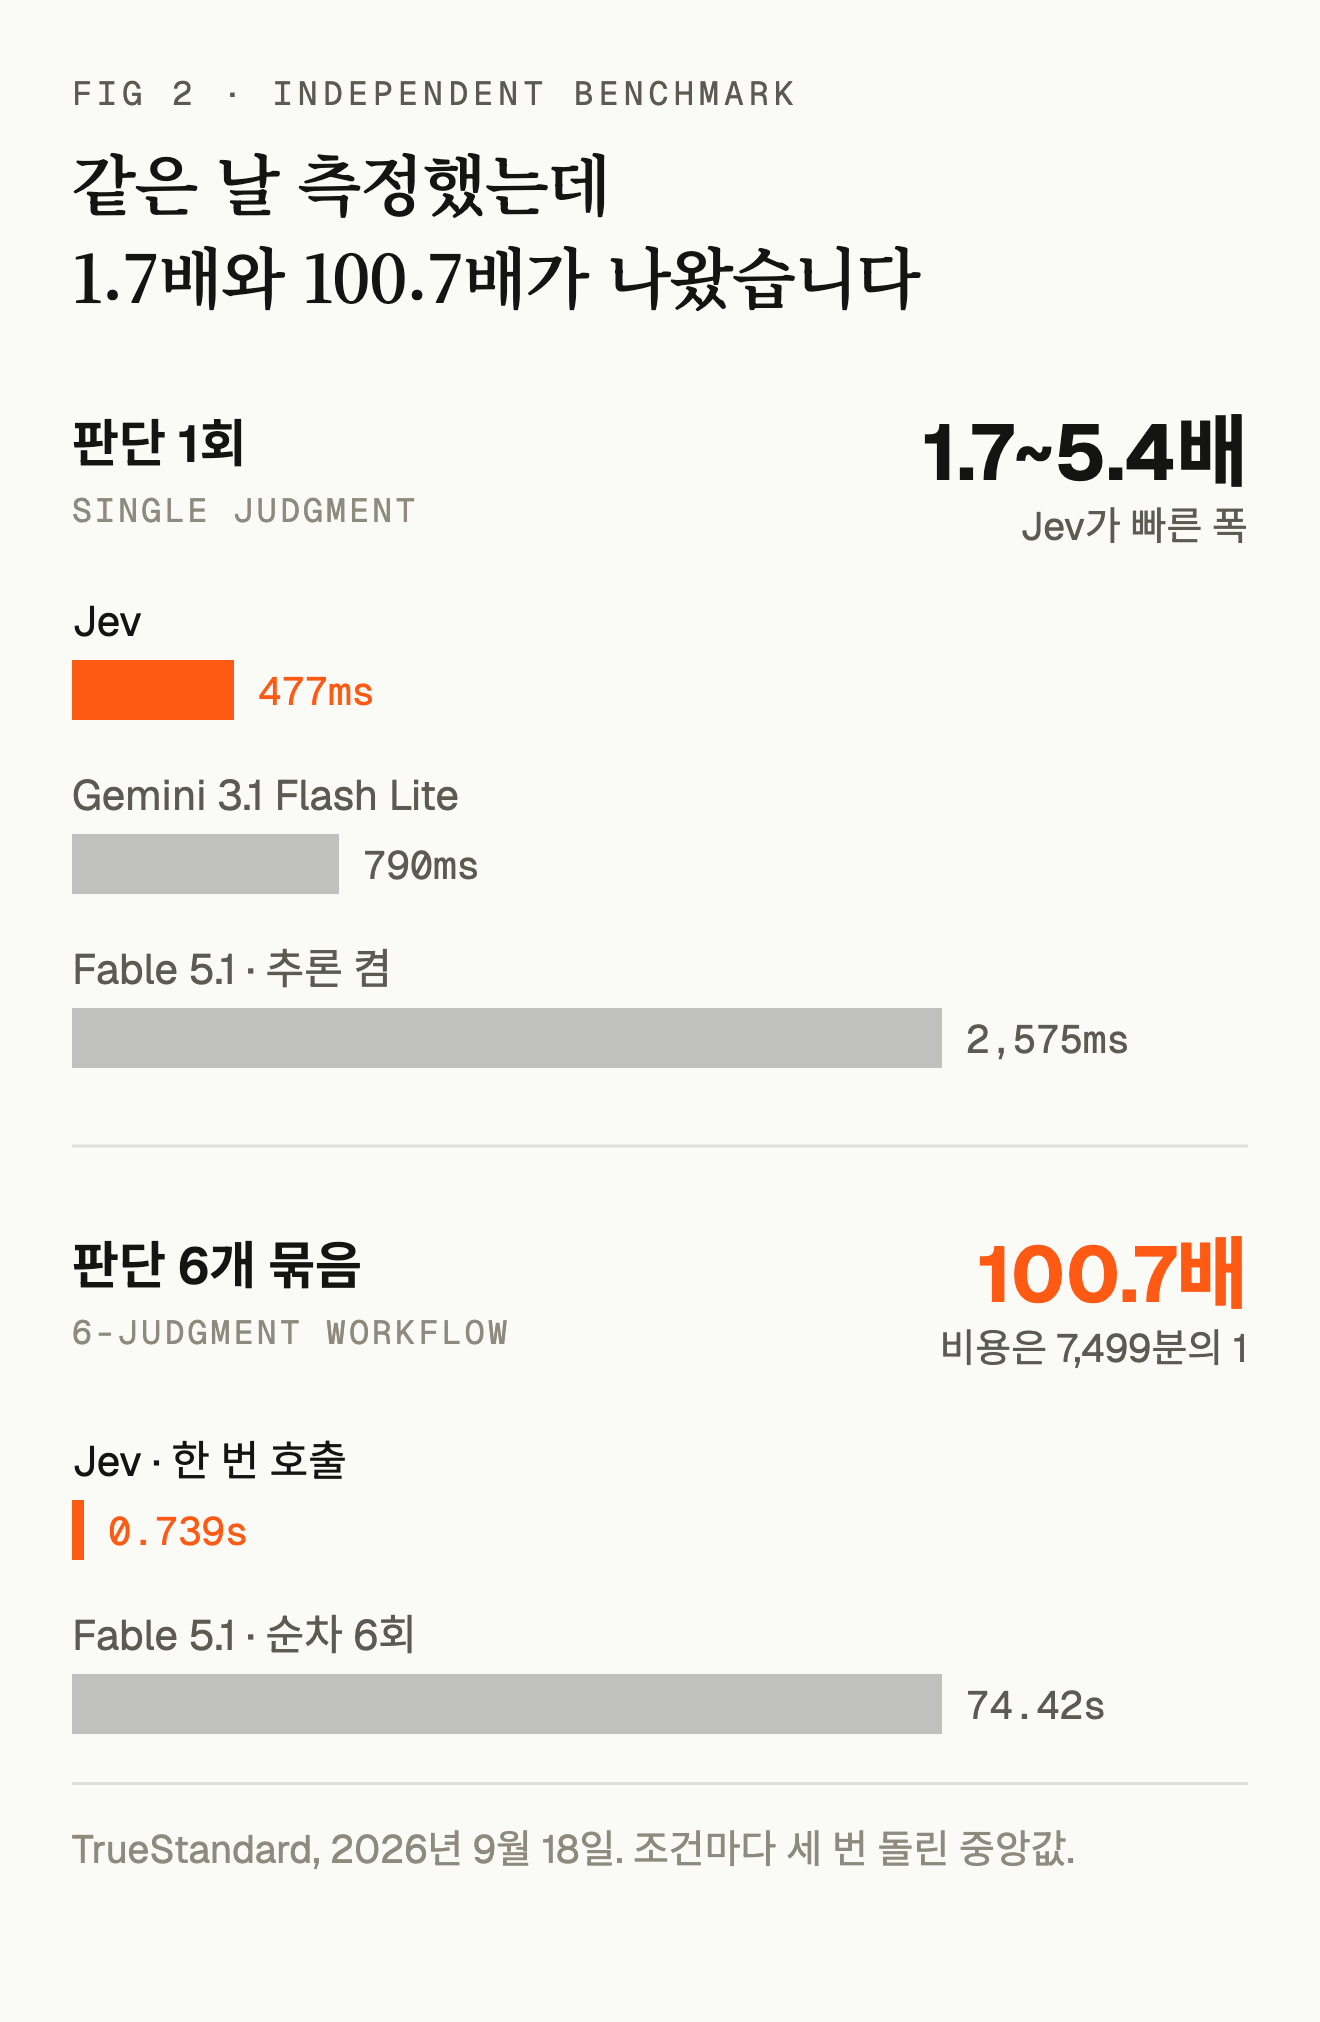
독립 측정에서 Jev는 판단 한 번짜리 작업에서 1.7~5.4배 빨랐습니다.
TrueStandard가 같은 작업을 세 번씩 돌려 중앙값을 냈어요. 판단을 한 번만 시키면 이렇습니다.
| 모델 | 응답 시간 |
|---|---|
| Jev | 477ms |
| Gemini 3.1 Flash Lite | 790ms |
| Fable 5.1 (추론 켬) | 2,575ms |
판단 여섯 개를 한 번에 묶으면 Jev가 훨씬 앞섭니다.
| 방식 | 시간 | 비용 |
|---|---|---|
| Fable을 여섯 번 차례로 | 74.42초 | $0.16251 |
| Jev를 한 번 | 0.739초 | $0.00002167 |
Jev가 100.7배 빠르고 7,499배 쌉니다. 같은 사람이 같은 날 측정한 결과예요. 저자는 이렇게 정리했습니다.
배수는 모델보다 비교 방식이 정한다.
SemIf라는 개인 프로젝트는 이 속도가 어디서 나오는지 집에서 확인했습니다. 게이밍 그래픽카드(RTX 3090)에 공개 모델 Qwen3.5-4B를 올렸어요. 답을 쓰게 하는 대신 선택지 확률을 바로 읽었고요.
| 방식 (질문 21개) | 시간 | 출력 |
|---|---|---|
| 선택지 확률 바로 읽기 | 1.023초 | 0토큰 |
| JSON으로 답 쓰게 하기 | 5.332초 | 111토큰 |
모델은 그대로 두고 답을 뽑는 방식만 바꿔서 속도를 5.21배 높였습니다.
실제로 만들어 봤습니다
카피 톤 검사기: 모델 호출 20분의 1
저는 블로그와 랜딩페이지 카피에 톤 규칙을 둡니다. 처음엔 규칙 36개를 코드(정규식)로 검사했어요. 그런데 정규식으로는 글자 모양만 잡고 뜻은 못 잡습니다. "시즌이 쌓여요"가 왜 어색한지 정규식으로는 알 수 없죠.
그래서 규칙 세 개를 Jev에게 넘겼습니다. 전부 예/아니오 확률로 묻는 규칙이에요.
- 사람이 아닌 것이 주어로 나오는지
- 문장이 명사로 뚝 끝나는지
- 같은 모양 문장을 억지로 나란히 놓았는지
쓰면서 세 가지를 정했어요.
- 경고만 띄웁니다. Jev가 문제를 찾아도 배포는 막지 않아요.
- 코드로 먼저 거릅니다. 물어볼 만한 조각만 Jev에 보냅니다.
- 코드 검사는 따로 돌립니다. Jev가 실패해도 끝까지 돌려요.
카피 파일 21개를 조각 1,353개로 나누고, 그중 709개를 Jev에 보냅니다. 질문은 1,411개인데 이걸 71번에 나눠 묶어 보내요.
질문마다 부르면 1,411번인데, 묶어서 71번만 불렀습니다. 모델 호출을 20분의 1로 줄인 셈이죠.
뉴스 고르는 에이전트: 1.8초 손해
다른 작업에서는 손해를 봤습니다. 브라우저를 띄워 뉴스 후보를 읽고 두 개를 고르는 에이전트예요. 후보 기사 8개를 고정해 놓고 Jev 없이 한 번, Jev를 넣어 한 번 돌렸습니다.
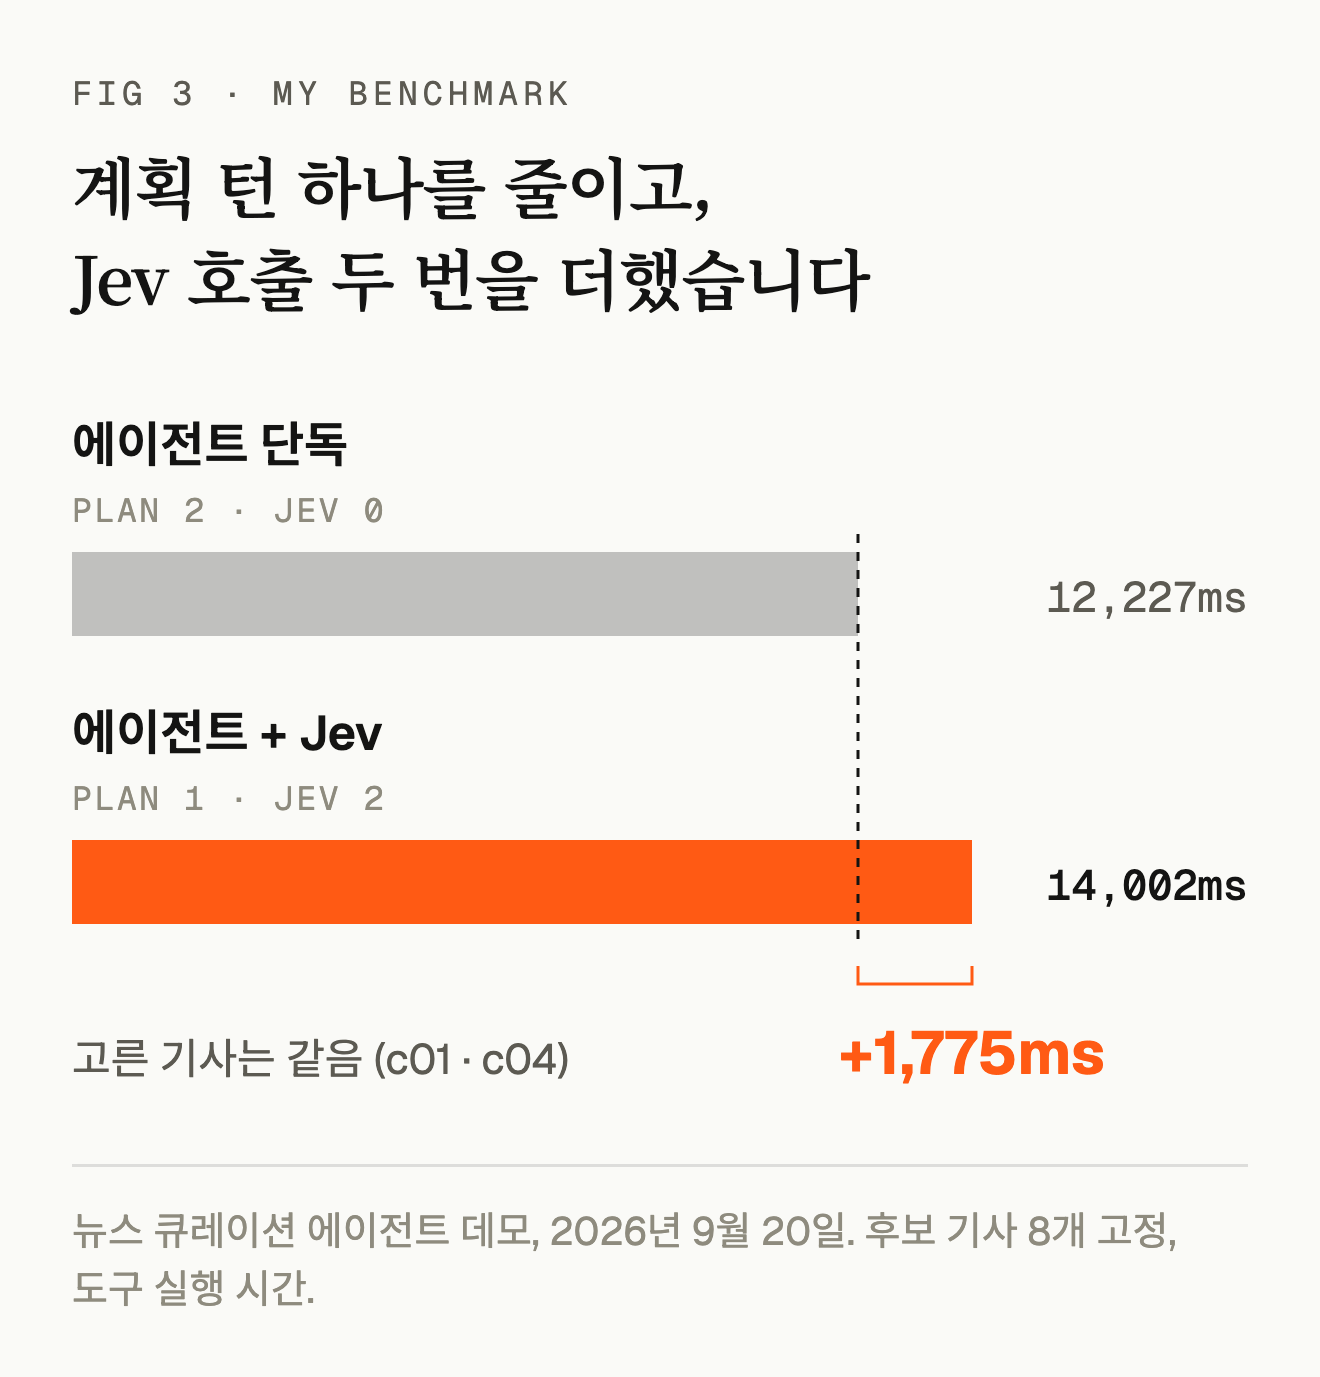
Jev가 에이전트의 계획 단계를 한 번 줄였습니다. 대신 Jev를 두 번 새로 불렀죠. 에이전트는 같은 기사를 골랐고요.
계획 한 번을 아끼려고 Jev를 두 번 불렀으니 얻은 게 없었습니다.
쓸지 말지는 판단 횟수로 정하세요
두 사례를 나란히 놓고 저는 기준을 하나로 정했습니다. 아끼는 호출보다 새로 부르는 Jev 호출이 적은가.
| 항목 | 카피 톤 검사기 | 뉴스 고르는 에이전트 |
|---|---|---|
| 한 번 돌 때 판단 수 | 1,411개 | 2개 |
| 묶어 보내기 | 71번으로 묶음 | 불가 |
| 결과 | 호출 20분의 1 | 1.8초 손해 |
TrueStandard의 1.7배와 100.7배도 같은 이치입니다. 판단을 한 번만 시키면 Jev가 조금 앞서고, 여섯 번을 묶으면 크게 앞서죠.
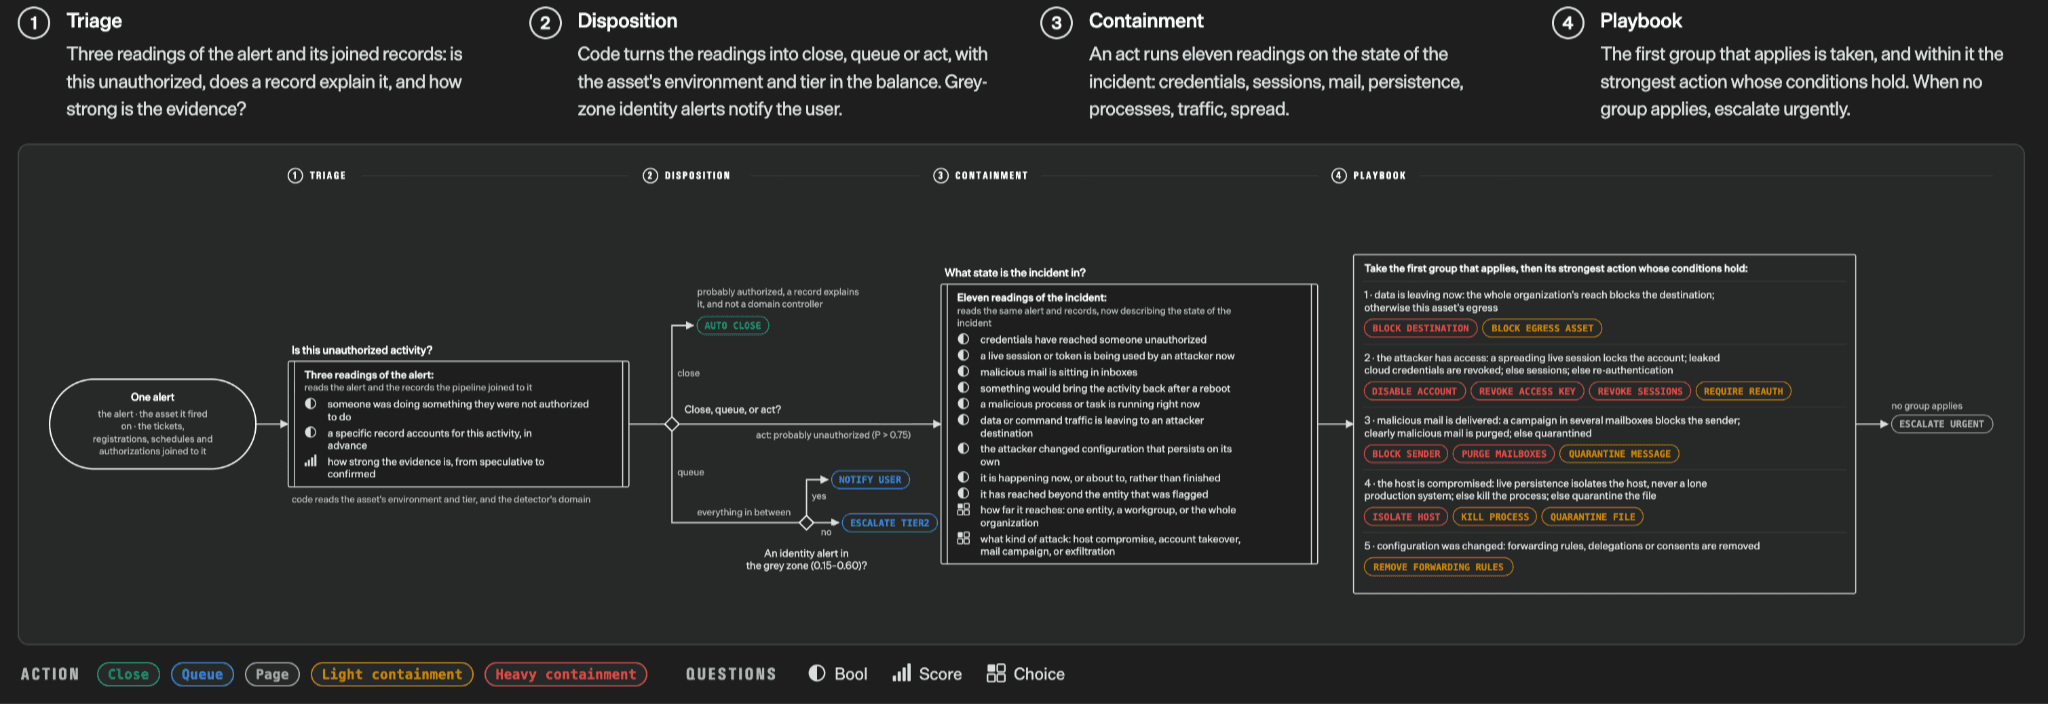
TypeSafe는 공개한 보안 사고 대응 예시를 딱 이런 구조로 짰어요. 경보 하나에 판단 세 개를 돌리고, 격리 단계에서는 판단 열한 개를 동시에 돌립니다. 이렇게 판단이 많은 작업에 Jev가 맞습니다.
오늘 해 볼 세 가지
- 판단이 몇 번 들어가는지 보세요. 한 작업에 두세 번이면 쓰지 마세요. 수십 번은 넘어야 써 볼 만합니다.
- 판단을 묶어 보낼 수 있는지 보세요. 묶을 수 없으면 판단이 많아도 얻는 게 적습니다.
- 쓰기 전후 시간을 비교해 보세요. 저처럼 1.8초 손해를 보고 알면 늦습니다.
다음 편에서는 속도 말고 나머지를 봅니다. Jev가 어떤 모양으로 답하는지, 선택지를 늘리면 Jev가 얼마나 더 틀리는지, 확률은 어디까지 믿어도 되는지요.
출처
- TypeSafe 공식: 런칭 발표
- 독립 측정: TrueStandard
- 재현·응용: SemIf · jev-ultrafast
- 제 실측:
stagehand-jev-live실행2026-09-20T09-40-27-233Z,fronmpt-academylib/tone-jev.ts
FAQ
자주 묻는 질문
- 정말 193배 빠른가요?
- 비교 방식에 따라 다릅니다. TrueStandard 독립 측정에서 판단 한 번짜리 작업은 1.7~5.4배였고, 판단 여섯 개를 한 번에 묶은 작업에서는 100.7배 빨랐어요.
- 어떤 작업에 써야 이득인가요?
- 한 작업에서 판단을 수십 번 넘게 하고, 그 판단을 한 번에 묶어 보낼 수 있는 작업입니다. 판단이 두세 번뿐이면 Jev 호출이 늘어나는 만큼 오히려 느려질 수 있어요.
SEASON 3
시즌3 「콘텐츠로 팔기」
AI와 콘텐츠를 만들고 고객에게 연결하는 4주
제가 에이전트로 조사하고 쓰고 파는 과정을 그대로 보여 드려요. 그다음 각자의 주제로 같이 만들어 봐요.
10월 2일 OT · 10월 5일부터 월·수 4주 · 10월 31일 오프라인
시즌3 커리큘럼 보기