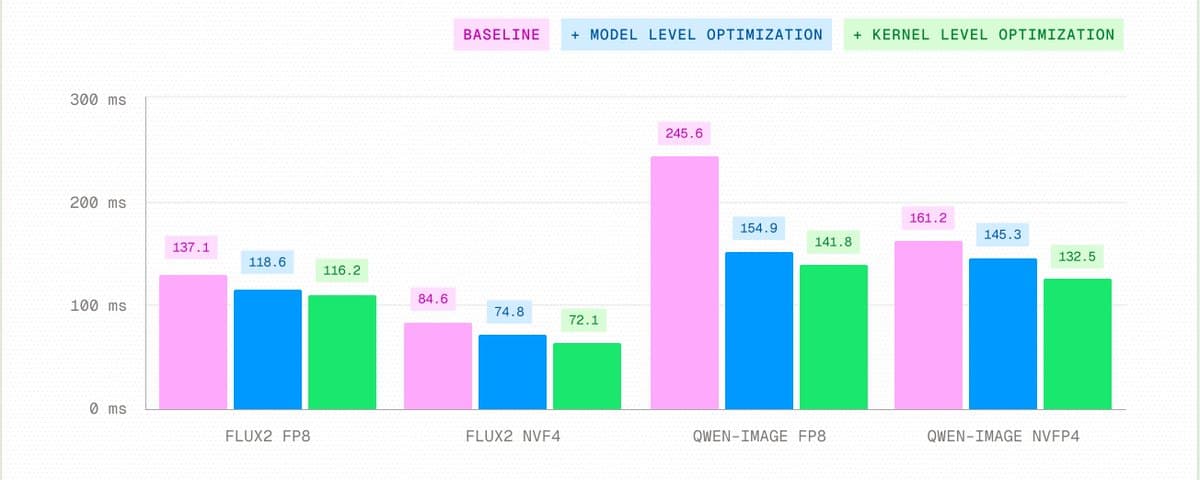
GPU 커널을 스스로 고치는 에이전트가 Qwen-Image 서빙에서 이미지 한 장 뽑는 시간을 42.3% 줄였습니다.
브라이언 리는 벤치마크 점수 대신 서비스 응답 시간, 즉 엔드투엔드 지연시간으로 측정했습니다.
공개한 사람은 Baseten에서 모델 성능을 맡은 브라이언 리입니다. 워털루대 컴퓨터공학을 다니고요. X에 올린 아티클 제목은 「The future of kernel engineering」이고, 사람들은 소개 트윗을 20만 번 넘게 조회했어요.
같은 프레임워크로 FLUX.2 지연은 15.2% 줄이고, MiniMax M3 처리량은 초당 토큰 기준 5.5% 늘렸습니다. 그는 전부 B300 GPU 위에서 SGLang 서빙 엔진으로 돌렸어요.
벤치마크 1등 커널은 왜 서비스에서 죽을까요?
브라이언 리는 글 앞머리에 이 문장을 박아뒀습니다.
"커널 벤치마크에서 이기는 일과 최적화를 프로덕션에 배송하는 일 사이에는 간극이 있다."
그는 간극을 넷으로 꼽습니다.
첫째, 워크로드마다 최적 설정을 다시 찾아야 합니다. 같은 커널이라도 배치 크기와 해상도를 바꾸면 가장 빠른 구성을 다시 골라야 해요. 벤치마크에서는 한 조건에서만 겨루니까 그 조건 밖에서는 다른 구성이 더 빠를 수 있습니다.
둘째, 마이크로벤치마크 속도로는 모델 속도를 알 수 없습니다. 저자 표현을 그대로 옮기면 "더 빠른 마이크로벤치마크가 곧 더 빠른 모델은 아니다"예요. 커널 하나를 30% 빠르게 해도 그 커널이 전체 시간의 3%만 차지하면 전체로는 1%밖에 못 줄입니다.
셋째, 커널을 하나씩 떼어놓고 보면 기회를 놓칩니다. 연산 두 개를 하나로 합치는 융합, 같은 값을 두 번 계산하는 중복 제거. 둘 다 커널 경계를 넘어야 보이는 기회라, 낱개 최적화로는 손이 닿지 않아요.
넷째, 누군가 서빙 엔진에 배선해야 합니다. 빠른 커널을 손에 쥐어도 SGLang 같은 엔진 안에 넣어 굴러가게 만들려면 따로 작업해야 해요.
그는 넷을 하나로 묶어 결론을 냅니다. 커널 하나를 잘 짜는 것만으로는 서비스를 빠르게 만들 수 없습니다.
에이전트는 어디부터 들여다볼까요?
에이전트는 네 단계를 한 바퀴로 돕니다.
모델 전체를 프로파일링해서 시간이 어디로 새는지 봅니다. 그 프로파일을 근거로 최적화를 제안합니다. 제안대로 커널을 생성하고, 마지막에 실제 서빙 스택 위에 올려 검증합니다.
저는 시작점을 핵심으로 봅니다. 에이전트는 모델 전체 프로파일에서 출발해요. 사람이 "이 커널을 빠르게 해달라"고 지정하는 대신, 에이전트가 느린 구간을 스스로 고릅니다.
에이전트는 최적화를 두 층으로 나눠 합니다.
모델 층에서는 연산을 합치고 지웁니다. QKV 계산과 뒷단 처리를 하나로 묶고, 정규화와 양자화를 합치고, 불필요한 연산을 아예 걷어냅니다. FP8 가중치를 미리 포장해 두는 최적화 하나로 두 모델에서 각각 7.3%, 6.1%를 줄였어요.
커널 층에서는 병렬 구현을 탐색합니다. 같은 연산을 짜는 방법 여러 개를 동시에 만들어 겨루게 하고, 가장 빠른 쪽을 남깁니다. Qwen-Image에서 이 층만으로 7.6%와 13.4%를 더 줄였습니다.
실패한 커널은 어디로 갈까요?
저는 이 프레임워크에서 이 대목이 가장 재미있었습니다.
에이전트는 통과한 커널을 지식베이스에 저장합니다. 여기까지는 예상 가능해요. 그런데 실패한 커널도 버리지 않습니다.
왜 틀렸는지, 어디서 어긋났는지를 교훈으로 적어 같이 저장합니다. 다음 최적화 때 에이전트는 그 기록을 읽고 출발합니다. 그래서 같은 벽에 두 번 부딪히지 않아요.
브라이언 리는 여기서 이런 그림을 그립니다.
"배포마다 실제 트래픽에 가장 잘 맞는 구현으로 계속 진화할 수 있다."
에이전트가 서비스 운영 내내 커널을 다시 짠다는 말입니다. 트래픽 모양이 바뀌면 최적 구성을 다시 찾아야 한다는 첫째 간극에 대한 답이기도 하고요.
42.3%는 어떤 항목을 더한 값일까요?
Qwen-Image 쪽부터 봅니다.
에이전트는 바이어스를 곱셈 안으로 흡수해 5.2%를 줄였습니다. 이 항목은 FP8 연산 단계 시간의 약 11%를 차지했어요.
CFG 캐시로 FP8에서 2.1%, NVFP4에서 3.1%를 줄였습니다. 여기에 앞서 본 커널 층 탐색 몫을 더합니다.
FLUX.2에서는 에이전트가 조금 다른 항목을 고쳤습니다.
에이전트는 QK 계산과 RoPE를 한 커널로 합쳐 속도를 2배 높였습니다. 이어붙이기 호출을 60번에서 12번으로 줄인 덕입니다. 전체 지연시간 기준으로는 2.3%와 4.0%를 줄였어요.
SwiGLU와 양자화를 합쳐 2.3%, 3.8%. 게이트 잔차 처리로 1.2%, 2.3%. 커널 층 탐색으로 1.9%, 2.8%.
숫자를 늘어놓고 보면 에이전트가 어떻게 일했는지 보입니다. 에이전트는 2%, 5%, 7%짜리 개선을 열 몇 개 모아 42%를 만들었습니다.
사람이 이걸 하려면 항목마다 며칠씩 매달려야 합니다. 개별 이득이 작으니 사람들은 이런 항목을 뒤로 미루고, 결국 영영 손대지 않습니다. 에이전트는 바로 이런 일을 잘해요.
이 방식은 이미지 모델 밖으로도 갈까요?
브라이언 리는 이미 넓히는 중입니다.
MiniMax M3에서는 초당 토큰 처리량을 5.5% 늘렸고, GLM-5.2도 대상에 올렸습니다. 언어 모델 쪽으로는 vLLM을 겨냥합니다.
이미지 모델과 언어 모델은 병목 위치가 다릅니다. 확산 모델은 같은 계산을 수십 번 반복하고, 언어 모델은 토큰을 한 개씩 뽑으며 메모리 대역폭에 먼저 막혀요. 그래서 언어 모델에서는 에이전트가 줄이는 폭이 훨씬 작습니다.
이미지 모델 쪽 두 자릿수와 언어 모델 쪽 한 자릿수를 나란히 두면 이 프레임워크가 어디서 힘을 쓰는지 알 수 있습니다. 연산이 무겁고 반복이 많을수록 에이전트가 고칠 곳이 많습니다.
남는 생각
저는 실패 기록이 진짜 자산이라고 봅니다.
이제 커널을 짜는 모델은 흔합니다. KernelBench에서 좋은 점수를 내는 모델은 여럿이고, 브라이언 리도 그 사실을 인정하고 글을 시작해요. 저는 안 되는 구현까지 기억하느냐로 승부가 난다고 봅니다.
통과한 답만 모으면 코드 창고에 그치지만, 실패까지 이유와 함께 모으면 그 배포에만 있는 지도를 얻습니다. 에이전트는 그 지도를 채운 뒤에 두 자릿수 단축을 냈어요.
저는 이 구조가 커널 밖에서도 같은 모양으로 반복될 거라고 봅니다. 사람이 손으로 튜닝하던 일, 이득이 작아 미뤄 두던 일을 에이전트가 서비스마다 알아서 맡게 됩니다.
저는 이 글에서 마지막 인용문을 가장 오래 붙들고 있었습니다. "배포마다 실제 트래픽에 가장 잘 맞는 구현으로." 최적화를 출시 전에 끝내는 일에서, 서비스가 사는 동안 계속하는 일로 옮긴다는 뜻이거든요.
원문·소스
- 브라이언 리 원문 트윗 (@BrianLi23): https://x.com/BrianLi23/status/2093487934448214351 (조회 20만)
FAQ
자주 묻는 질문
- 벤치마크 1등 커널은 왜 서비스에서 죽을까요?
- 최적 설정이 워크로드마다 달라지고, 마이크로벤치마크 속도가 모델 속도를 대변하지 못하기 때문입니다. 커널 하나를 30% 당겨도 그 커널이 전체 시간에서 3%면 최종 이득은 1%에 그칩니다.
- 에이전트는 어디부터 들여다볼까요?
- 에이전트는 커널 목록 대신 모델 전체 프로파일에서 출발합니다. 프로파일링, 최적화 제안, 커널 생성, 서빙 스택 검증 네 단계를 한 바퀴로 돌면서 느린 구간을 스스로 고릅니다.
- 실패한 커널은 어디로 갈까요?
- 에이전트는 실패한 커널도 통과한 커널과 나란히 지식베이스에 넣습니다. 왜 틀렸고 어디서 어긋났는지를 교훈으로 적어 두고, 다음 최적화 때 그 기록을 읽고 출발합니다.
- 42.3%는 어떤 항목을 더한 값일까요?
- 바이어스를 곱셈 안으로 흡수하는 최적화가 5.2%, CFG 캐시가 FP8에서 2.1%와 NVFP4에서 3.1%를 줄였습니다. 여기에 에이전트가 커널 층 탐색으로 벌어 온 7.6%와 13.4%를 더합니다.
- 이 방식은 이미지 모델 밖으로도 갈까요?
- 브라이언 리는 MiniMax M3에서 초당 토큰 처리량을 5.5% 늘렸고, GLM-5.2도 대상에 올렸습니다. 언어 모델 쪽 확장은 vLLM을 겨냥합니다.
SEASON 3
시즌3 「콘텐츠로 팔기」
AI와 콘텐츠를 만들고 고객에게 연결하는 4주
제가 에이전트로 조사하고 쓰고 파는 과정을 그대로 보여 드려요. 그다음 각자의 주제로 같이 만들어 봐요.
10월 2일 OT · 10월 5일부터 월·수 4주 · 10월 31일 오프라인
시즌3 커리큘럼 보기