출시 48시간 반응만 보면 데모 경연처럼 보여요.
xAI는 공식문에서 방향을 다르게 잡았습니다. 4.5 위에 그록 4.6을 올렸고, 오래 가는 에이전트와 더 공들인 시각·인터랙티브 작업에 초점을 맞췄죠.
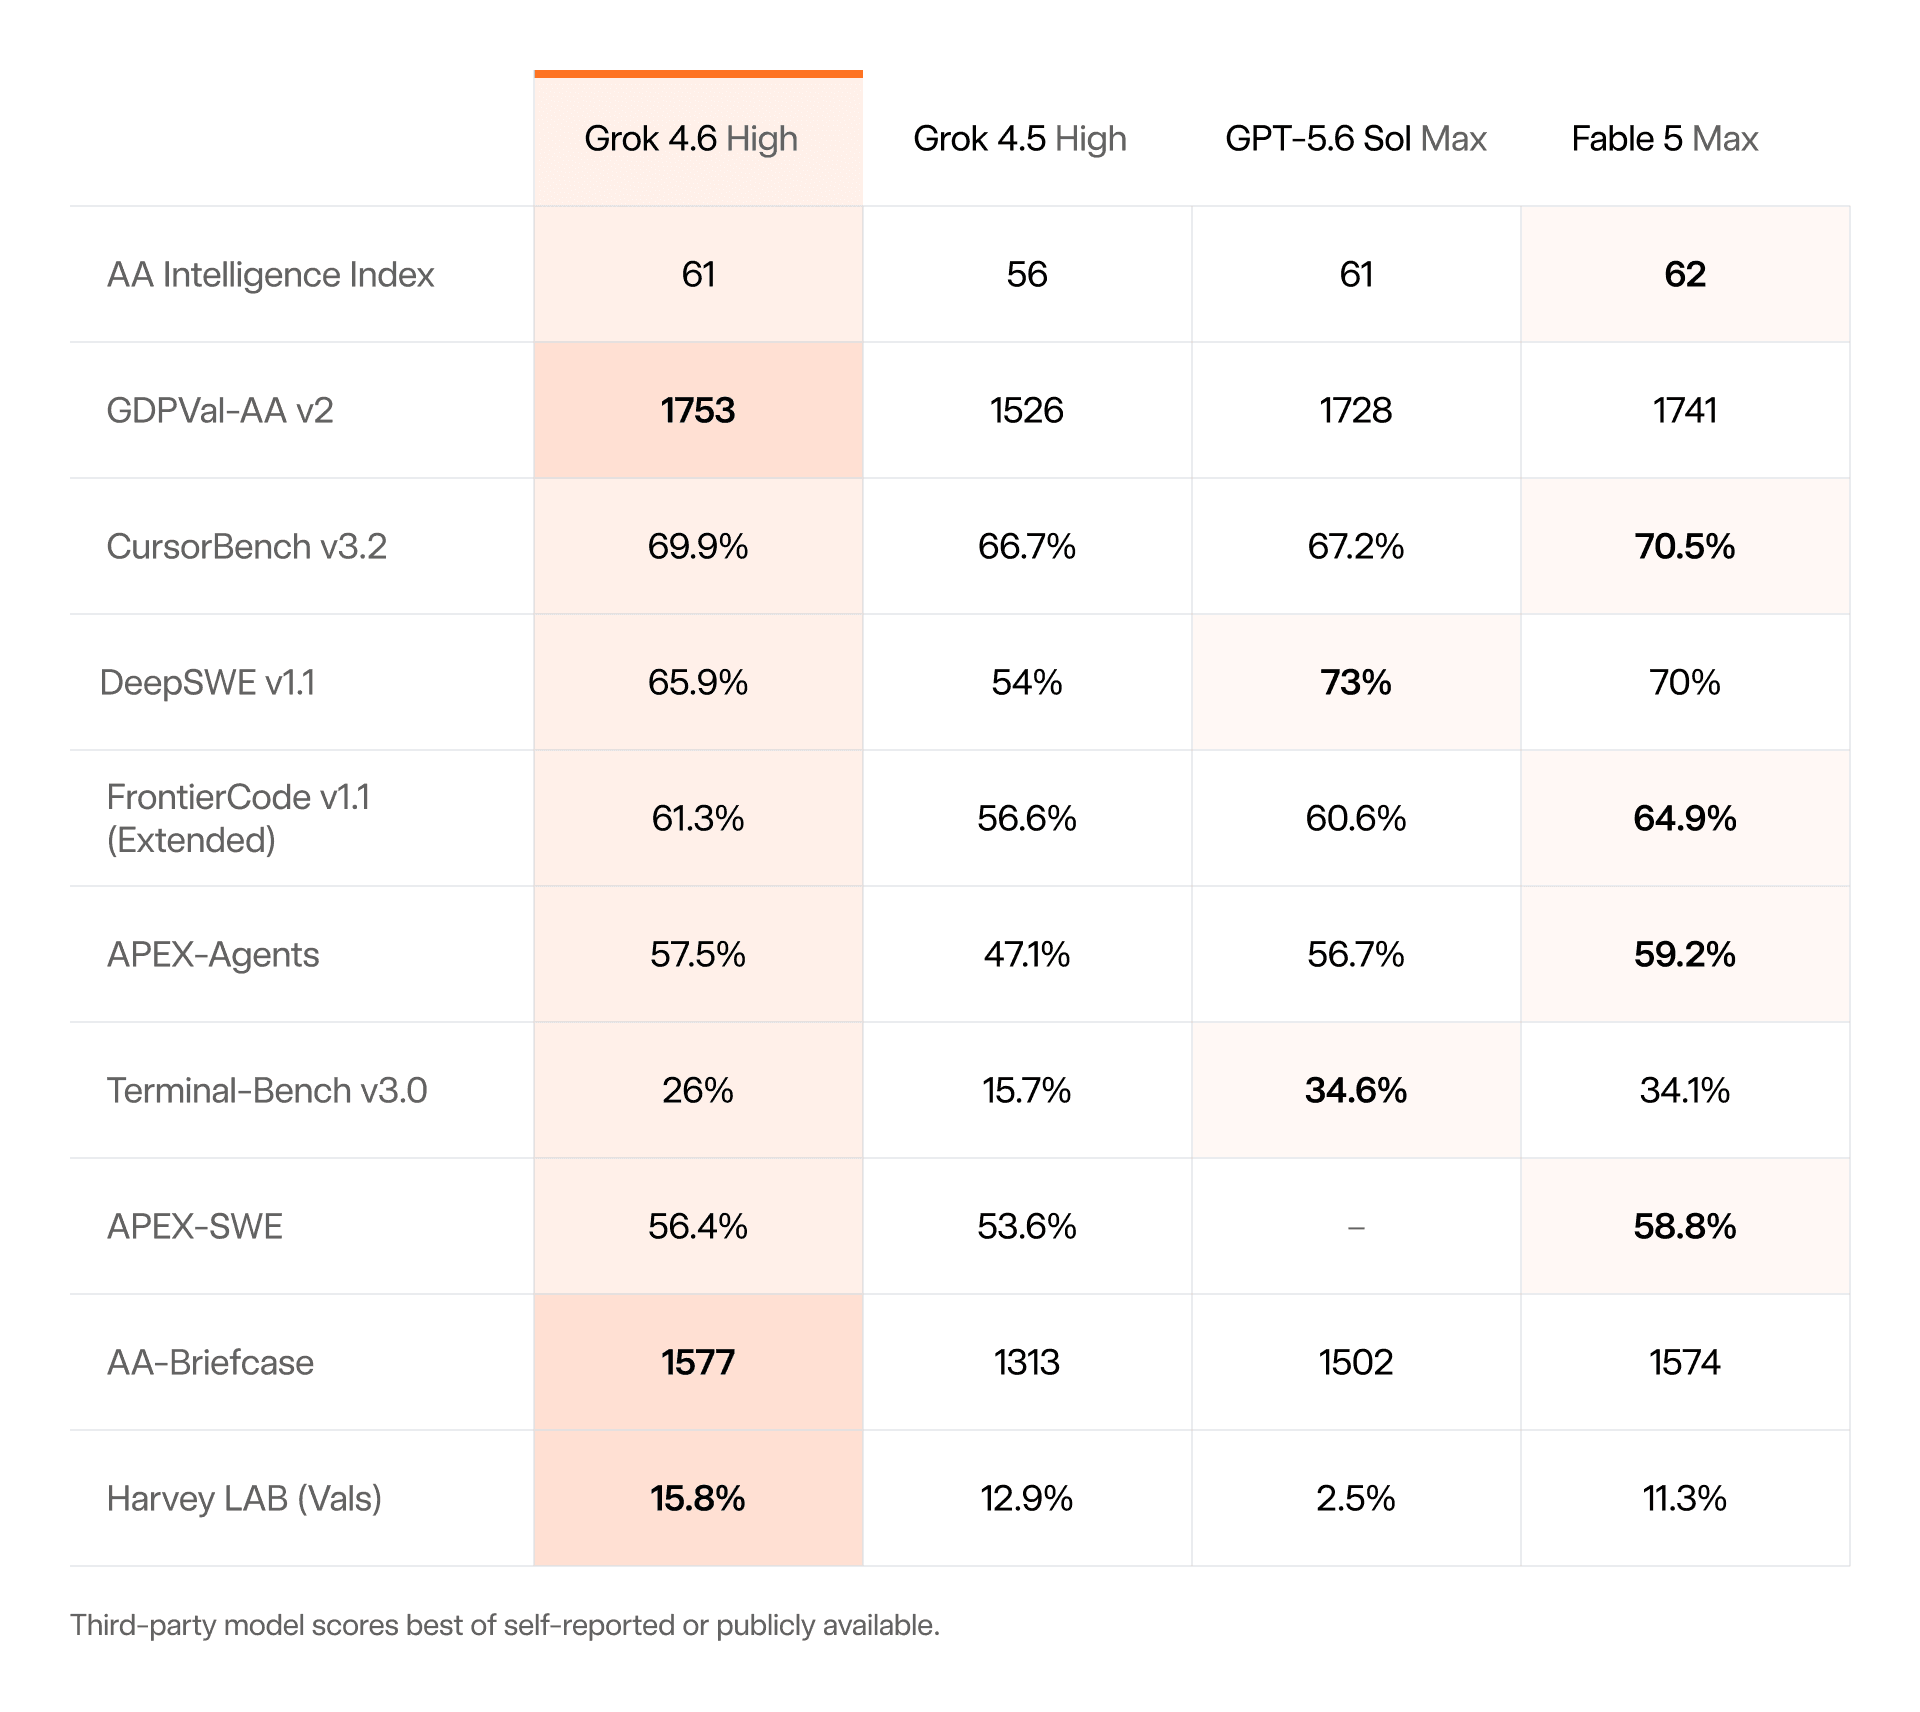
xAI는 숫자로도 그 방향을 보여 줍니다. 공식 표에서 그록 4.6 High는 AA Intelligence Index 61로 GPT-5.6 Sol Max와 나란히 섰지만, Terminal-Bench v3.0에서는 26%로 아직 뒤처져요.
어디서 앞서고 어디서 뒤처지는지부터 정리할게요.
그록 4.6에서 무엇이 바뀌었나요?
xAI는 발표를 한 줄로 요약했어요. 복잡한 일을 여러 단계에 걸쳐 붙잡고 있으라는 겁니다. 조사, 분석, 코드베이스 작업, 아이디어를 실제 결과물로 만드는 일이요.
xAI는 학습 과정도 그 초점에 맞췄어요. 4.5보다 긴 보충 학습을 돌렸고, 추론·공학 데이터와 개선된 옵티마이저를 넣었습니다.
그다음 그록 4.5로 SFT 궤적을 다시 만들고, 에이전트 하네스와 STEM·소프트웨어·지식 업무 궤적에서 문제 있는 트레이스를 걸러냈죠.
xAI는 강화학습 환경도 넓혔어요. 일반 코딩에 더해 커널 최적화, 웹 개발, CAD 같은 도메인 환경을 넣었다고 적었습니다. 빌더들이 게임과 웹사이트 데모를 쏟아낸 것도 우연이 아닐 수 있어요.
xAI는 곧바로 제품에도 넣었어요. Cursor와 Grok Build에서 당일 열었고, 첫 주 포함 사용량을 2배로 줬습니다. API와 OpenRouter, Vercel, Cloudflare에도 올렸어요.
왜 오래 가는 에이전트가 초점인가요?
프론티어 회사들이 "한 방 답"보다 "오래 가는 작업"에 공을 들입니다. 오픈AI도 GPT-5.6 빌더 가이드에서 같은 말을 합니다. 더 긴 작업을 더 적은 토큰으로, 하네스를 크게 안 바꾸고도 되게 만들겠다는 쪽이죠.
xAI가 그록 4.6에서 강조한 행동도 같은 방향입니다. 넓은 제품 아이디어를 동작하는 1차로 만들고, 피드백을 여러 라운드 받으며 다듬습니다. 긴 궤적에서는 그록이 스스로 테스트하고 검증하는 모습을 더 보인다고 했어요.
xAI는 그록 4.6이 시각·인터랙티브 작업의 첫 패스를 4.5보다 잘 만든다고 했어요. 빌더들이 48시간 동안 올린 데모를 보면 이 말과 맞습니다.
xAI는 가격도 소넷 5와 비슷하게 매겼어요. 입력 100만 토큰당 2달러, 출력은 6달러입니다. 빠른 변형은 두 배죠. 회사들이 에이전트 기본 단가를 2달러대에 맞추고 있어요.
벤치마크 숫자는 어떤가요?
공식 표에서 그록 4.6 High는 AA Intelligence Index 61을 받았어요. GPT-5.6 Sol Max와 같고, 페이블 5 Max 62에 가깝습니다. 4.5 High는 56이었죠.
그록 4.6은 다른 벤치에서도 점수를 올렸어요. GDPVal-AA v2에서 1753으로 4.5의 1526을 넘었고, 페이블 5 Max 1741도 살짝 앞섰습니다. CursorBench v3.2에서는 69.9%로 4.5의 66.7%를 넘었지만, 페이블 5 Max 70.5%에는 못 미쳐요.
xAI는 약한 항목도 표에 넣었어요. DeepSWE v1.1에서는 65.9%로 4.5의 54%를 넘었지만, GPT-5.6 Sol Max 73%, 페이블 5 Max 70%보다 낮습니다. Terminal-Bench v3.0에서는 26%를 받았죠. 4.5의 15.7%보다는 높지만, GPT-5.6 34.6%와 페이블 5 34.1%에는 못 미칩니다.
xAI도 모든 항목에서 1등을 주장하지는 않아요. 그록 4.6은 종합 지수와 지식 업무·시각 빌드 쪽에서 앞서고, 터미널 벤치와 일부 SWE 항목에서는 아직 뒤처집니다.
저는 패트릭 콜리슨이 터미널 하네스를 비판한 맥락과도 겹쳐 봅니다. 그록이 자랑하는 작업과 터미널 벤치가 평가하는 작업은 같은 기술이 아닐 수 있어요.
나머지 항목에서도 비슷해요. FrontierCode v1.1 Extended 61.3%, APEX-Agents 57.5%, APEX-SWE 56.4%. 그록 4.6은 세 항목 모두 4.5보다 큰 폭으로 끌어올렸고, GPT-5.6·페이블 5 Max와 비슷한 구간에 있습니다.
AA-Briefcase에서는 1577로 페이블 5 Max 1574와 거의 같고, Harvey LAB에서만 15.8%로 경쟁 모델을 앞섰어요. xAI는 모든 항목을 이기기보다 에이전트·지식 업무 묶음에서 4.5를 끌어올렸죠.
학습 데이터는 무엇을 말하나요?
저는 데모보다 학습 이야기가 더 기억할 만하다고 봅니다. 4.5로 SFT 궤적을 다시 만들고, 에이전트 하네스 궤적에서 문제 트레이스를 걸렀습니다. 그다음 에이전트 RL을 커널, 웹, CAD 환경까지 넓혔죠.
그록이 "예쁜 첫 화면"을 잘 만드는 건 마케팅 문장 덕이기 전에, xAI가 학습 데이터에 그런 작업을 넣은 덕이에요.
같은 주 OpenAI도 빌더 가이드에서 같은 숙제를 다룹니다. GPT-5.6도 더 긴 작업을 더 싼 가격-성능으로, 하네스를 크게 안 바꾸고 돌리게 만들겠다고 적었어요. 회사들은 이제 채팅 점수보다 에이전트를 얼마나 오래 돌리는지로 경쟁합니다.
한계와 반론은 무엇인가요?
저는 48시간 빌더 반응을 근거로 삼기엔 약하다고 봅니다. 빌더들은 잘 된 데모만 골라 올리고, 실패작은 올리지 않으니까요. xAI가 말하는 자기 검증을 그록이 실제 제품에서 얼마나 자주 하는지도 아직 외부에서 재현한 사람이 없습니다.
벤치 숫자는 xAI가 직접 만든 표예요. xAI는 경쟁 모델 점수에 "self-reported 또는 공개 결과 중 최고"라는 주석을 달았습니다. 같은 조건의 독립 평가로 읽으면 안 돼요.
xAI는 안전 문단을 짧게 썼죠. 가드레일을 능력에 맞춰 조정했고, 취약점 패치와 엔지니어링 설계, AI 연구 지원 같은 합법 용도를 열겠다고 했습니다. 사전·사후·제3자 테스트를 넓혔다는 주장 외에, 생물학처럼 폴백 수치를 구체로 내놓지는 않았어요.
빠른 변형은 두 배 가격이라 조심해야 합니다. 기본 2/6을 보고 예산을 잡았다가 지연이 싫어 패스트로 바꾸면 두 배를 내야 해요.
어떤 기준으로 판단하면 되나요?
그록 4.6을 "코딩 1등"으로 사지 마세요. xAI가 공식문에서 미는 구간은 긴 에이전트 궤적과, 아이디어를 동작하는 시각 결과물로 만드는 1차 패스예요.
비교할 때는 세 줄을 같이 보세요. AA 지수 61, CursorBench 69.9%, Terminal-Bench 26%. 앞의 두 줄만 보면 프론티어급이지만, 그록 4.6은 터미널 작업에서 아직 다른 모델에 뒤처집니다.
소넷 5와 같이 써 볼 수도 있어요. 실행 단가는 둘 다 입력 2달러대입니다. 앤트로픽은 소넷 5의 에이전트 실행 층과 캐시 구조를 문서로 정리해 뒀고, xAI는 그록 4.6의 시각 1차 패스와 긴 루프를 전면에 내세우죠.
한 모델로 모든 루프를 덮기보다 작업 종류에 따라 모델을 나눠 쓰는 편이 표와 맞습니다.
남는 생각
저는 이번 표를 경쟁 방향이 바뀌는 신호로 읽습니다.
데모는 하루 구경하면 충분해요. 어떤 벤치에서 앞서고 어떤 벤치에서 뒤처지는지를 기억해 두면 됩니다.
원문·소스
- 공식 발표: https://x.ai/news/grok-4-6
- Cursor 측 소개: https://cursor.com/blog/grok-4-6
- GitHub Copilot 제공: https://github.blog/changelog/2026-08-14-grok-4-6-is-now-available-in-github-copilot/
- OpenAI 빌더 가이드(같은 주간의 가격-성능 축): https://openai.com/index/builders-guide-to-gpt-5-6/
- 그록 4.6 벤치마크 이미지: https://ptht05hbb1ssoooe.public.blob.vercel-storage.com/assets/blog/evals-4.6-space-x-03-light-RfPXLdwnvrX89InlepuJovKbmJkQB1.png
FAQ
자주 묻는 질문
- 그록 4.6에서 무엇이 바뀌었나요?
- xAI가 4.5 위에 올린 모델로, 초점은 복잡한 일을 여러 단계에 걸쳐 붙잡고 있는 오래 가는 에이전트입니다. xAI는 4.5보다 긴 보충 학습을 돌렸고, 출시 당일 Cursor와 Grok Build에 열면서 첫 주 포함 사용량을 2배로 줬습니다.
- 왜 오래 가는 에이전트가 초점인가요?
- 프론티어 연구소들이 한 방 답에서 오래 가는 작업으로 경쟁 무대를 옮기고 있어서예요. 오픈AI의 GPT-5.6 빌더 가이드도 더 긴 작업을 더 적은 토큰으로 되게 만들겠다는 같은 말을 합니다. xAI는 가격도 입력 100만 토큰당 2달러, 출력 6달러로 잡아 소넷 5와 같은 가격대에 올렸습니다.
- 벤치마크 숫자는 어떤가요?
- AA Intelligence Index 61로 GPT-5.6 Sol Max와 같고 페이블 5 Max 62에 가깝습니다. GDPVal-AA v2 1753, CursorBench v3.2 69.9%로 4.5를 앞섰지만, Terminal-Bench v3.0에서는 26%로 GPT-5.6 34.6%와 페이블 5 34.1%에 못 미칩니다.
- 학습 데이터는 무엇을 말하나요?
- xAI는 그록 4.5로 SFT 궤적을 다시 만들고 에이전트 하네스 궤적에서 문제 트레이스를 걸렀습니다. 에이전트 RL도 일반 코딩에서 커널 최적화, 웹 개발, CAD 환경까지 넓혔어요. 빌더들이 게임과 웹사이트 데모를 쏟아낸 것도 우연이 아닐 수 있습니다.
- 한계와 반론은 무엇인가요?
- 벤치 숫자는 회사 표이고, 경쟁 모델 점수는 self-reported 또는 공개 결과 중 최고라는 주석이 달려 있습니다. 48시간 빌더 반응은 선택 편향이 크고, 빠른 변형이 기본 가격의 두 배라는 점도 함정이 될 수 있어요.
- 어떤 기준으로 판단하면 되나요?
- AA 지수 61, CursorBench 69.9%, Terminal-Bench 26% 세 줄을 같이 보면 됩니다. 앞의 두 줄만 보면 프론티어고, 세 번째 줄을 보면 터미널 작업은 아직 다른 모델 뒤에 있습니다.
SEASON 3
시즌3 「콘텐츠로 팔기」
AI와 콘텐츠를 만들고 고객에게 연결하는 4주
제가 에이전트로 조사하고 쓰고 파는 과정을 그대로 보여 드려요. 그다음 각자의 주제로 같이 만들어 봐요.
10월 2일 OT · 10월 5일부터 월·수 4주 · 10월 31일 오프라인
시즌3 커리큘럼 보기