
1편에서는 Jev로 도구 두 개를 실제로 만들고 속도와 호출 수를 비교했습니다. 저는 판단 횟수에서 이유를 찾았어요. 판단이 많은 작업에서는 이득을 봤고, 두세 번뿐인 작업에서는 오히려 손해를 봤죠.
이번 편에서는 속도 말고 나머지를 봅니다.
- Jev는 어떤 모양으로 답하는지
- 선택지를 늘리면 Jev가 얼마나 더 틀리는지
- TypeSafe가 가장 크게 내세우는 확률을 어디까지 믿어도 되는지
글에 나오는 용어는 Jev 용어집에 모아 뒀어요.
답은 세 가지 모양뿐입니다
Jev를 만든 사람은 디오고 알메이다입니다. OpenAI에서 ChatGPT의 바탕이 된 학습법(RLHF)을 함께 만든 연구자예요. 그는 TypeSafe AI를 세우며 이렇게 물었습니다.
전구가 천지에 깔렸는데, 경제가 뒤집혔다는 소식은 대체 어디 있습니까?
사람들이 채팅창은 넘치게 쓰는데 왜 자동화는 늘리지 못했느냐는 거죠.
그는 이렇게 봅니다. 실제 자동화에서 사람과 나누는 대화는 1%고, 나머지 99%는 프로그램끼리 주고받는 신호예요. 프로그램은 긴 문장을 원하지 않습니다. 바로 분기에 쓸 수 있는 값을 원하죠.
그래서 Jev는 세 가지 모양으로만 답합니다.
| 모양 | 하는 일 | 코드로 치면 |
|---|---|---|
| 고르기 (Choice) | 선택지 하나를 고르고 확률을 매김 | match 문 |
| 점수 (Score) | 정해 둔 단계 위에 위치를 매김 | 정렬 |
| 예/아니오 (Noul) | '예'일 확률을 0~1로 냄 | if 문 |
"이 문의는 결제·주문·반품·계정 중 어디로 보낼까?"라고 물으면 Jev가 이런 값을 돌려줍니다.
{ "type": "choice", "choice": "returns",
  "probabilities": { "billing": 0.01, "orders": 0.01, "returns": 0.95, "account": 0.03 },
  "confidence": 0.92 }
반품(returns)일 확률이 0.95라는 뜻이에요.
요금은 100만 토큰 기준입니다. 맨 오른쪽 칸을 꼭 같이 보세요.
| 항목 | 기존 AI | Jev 1.13 | 확인할 것 |
|---|---|---|---|
| 입력 | $0.20~$10 | $0.042 | 회사 발표 |
| 출력 | 입력의 약 5배 | 무료 | 회사 발표 |
| 응답 | 수 초~수십 초 | 70~500ms | 회사가 고른 작업 |
| 확신도 | 과신, 물을 때마다 다름 | 모든 답에 확률 | 보정 데이터 미공개 |
네 줄 중 세 줄이 회사가 낸 숫자예요. 직접 측정한 사람들의 숫자를 따로 봐야 합니다.
Jev는 선택지가 적을 때 강합니다
선택지 2~4개 과제에서는 Jev가 가장 정확했습니다. 77개짜리 의도 분류에서는 GPT 계열보다 덜 정확했고요.
Aman Kumar가 공개 데이터 네 종에 1만 6천 번을 호출해 정확도를 측정했어요.
| 데이터 | 선택지 | Jev | gpt-5.4-mini | gpt-5.6-luna |
|---|---|---|---|---|
| Enron 스팸 | 2 | 98.7% | 97.7% | 98.0% |
| SST-2 감성 | 2 | 95.7% | 92.7% | 93.0% |
| AG News 주제 | 4 | 91.3% | 88.3% | 89.7% |
| Banking77 의도 | 77 | 76.0% | 78.7% | 81.7% |
저자는 질문 문구만 바꿔도 Jev 정확도를 5%p씩 올리거나 내릴 수 있었다고 적었습니다.
TypeSafe가 공개한 평가도 보겠습니다. 가로축이 비용, 세로축이 정확도예요. Jev는 맨 왼쪽에 홀로 떨어져 있습니다. Jev는 중간급 AI와 비슷하게 맞히는데, 쓰는 사람은 비용을 10분의 1에서 100분의 1만 냅니다.
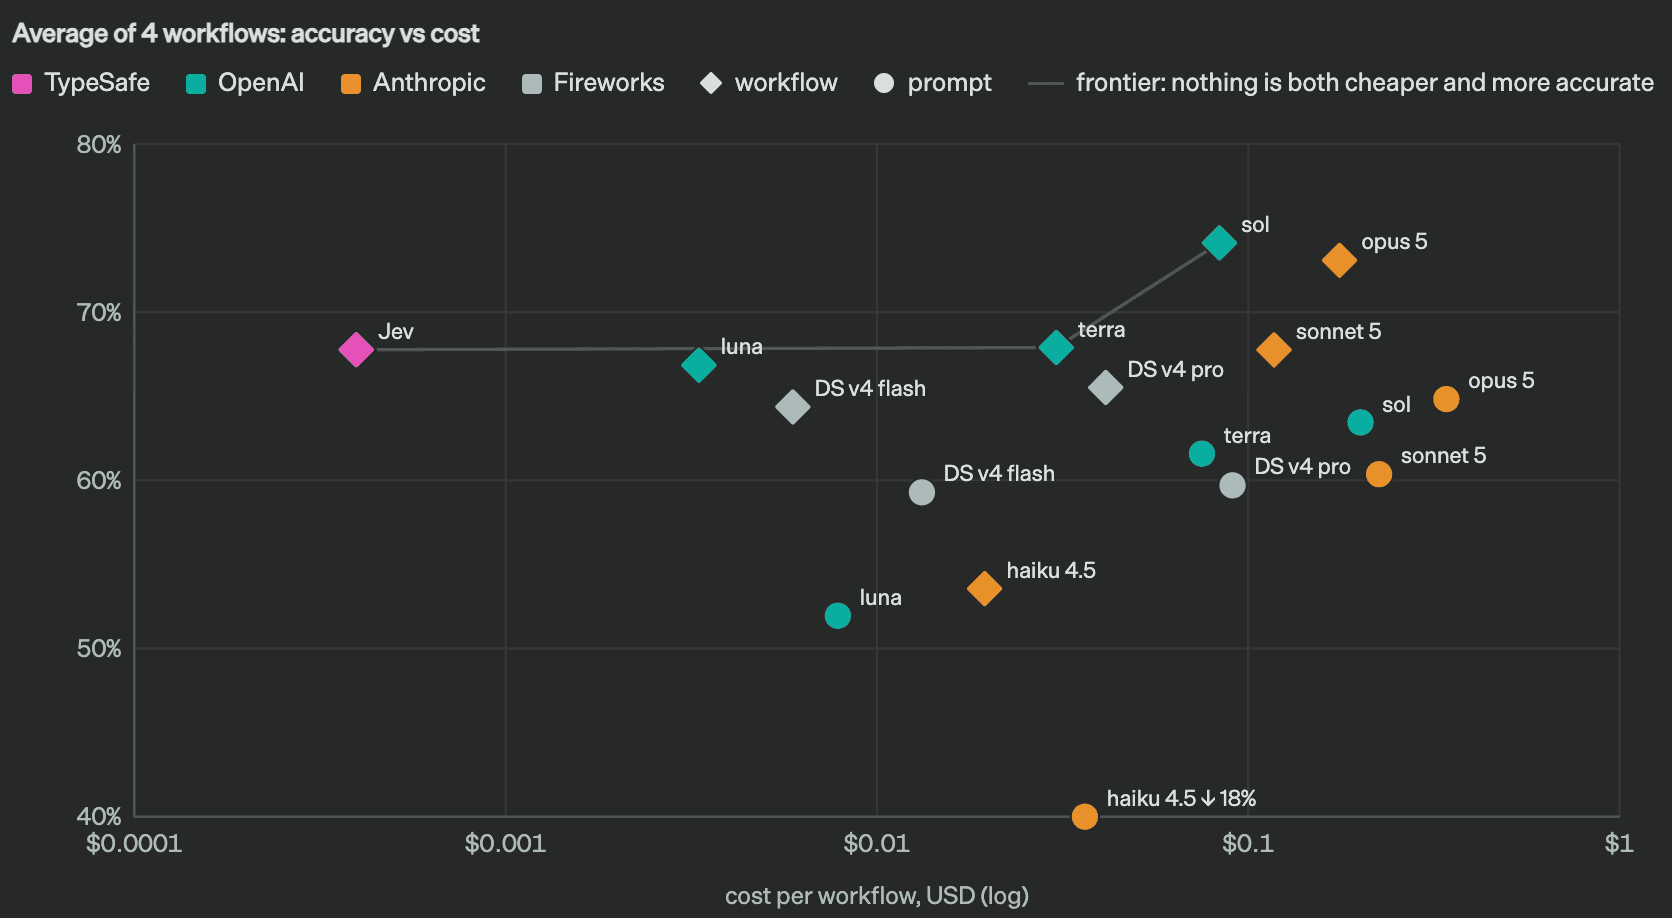
작업별로 보면 Jev는 고객 응대에서 가장 정확한 AI보다 2.3%p, 인보이스 처리에서 17.3%p 뒤져요.
TypeSafe는 못 하는 것도 문서에 먼저 적어 뒀습니다. 제가 실무에서 바로 부딪힐 만한 건 네 가지예요.
- 숫자 계산. TypeSafe는 계산을 코드로 빼라고 적어 뒀어요.
- 날짜와 시간 비교. 날짜 뽑기만 맡기고 비교는 코드로 합니다.
- 잡다한 정보가 많은 입력. 길고 잡다할수록 Jev가 오판해요.
- 묻는 모양을 바꾸면 Jev도 다르게 답함. 같은 질문인데 예/아니오로 물으면 0.22, 고르기로 물으면 '아니오'를 0.99로 내기도 합니다.
한국어는 직접 테스트해 보셔야 합니다. 공식 문서는 영어가 주력이고, 한중일 문자는 처리하지만 같은 수준은 아니라고 적어 뒀어요.
애매한 구간은 사람에게 넘깁니다
TypeSafe는 속도보다 확률을 내세웁니다. 회사는 이렇게 설명합니다.
95%를 맞혀도 틀리는 5%가 언제인지 말해 주지 못하면 그 일은 자동화할 수 없다.
그래서 TypeSafe는 학습 방식부터 다르게 가져갔습니다.
- 채팅 모델: 사람이 더 좋아하는 답으로 다듬습니다(RLHF).
- 추론 모델: 자동 채점되는 정답으로 다듬어요(RLVR).
- Jev: 확률이 실제 결과와 맞도록 다듬었습니다(RLCD).
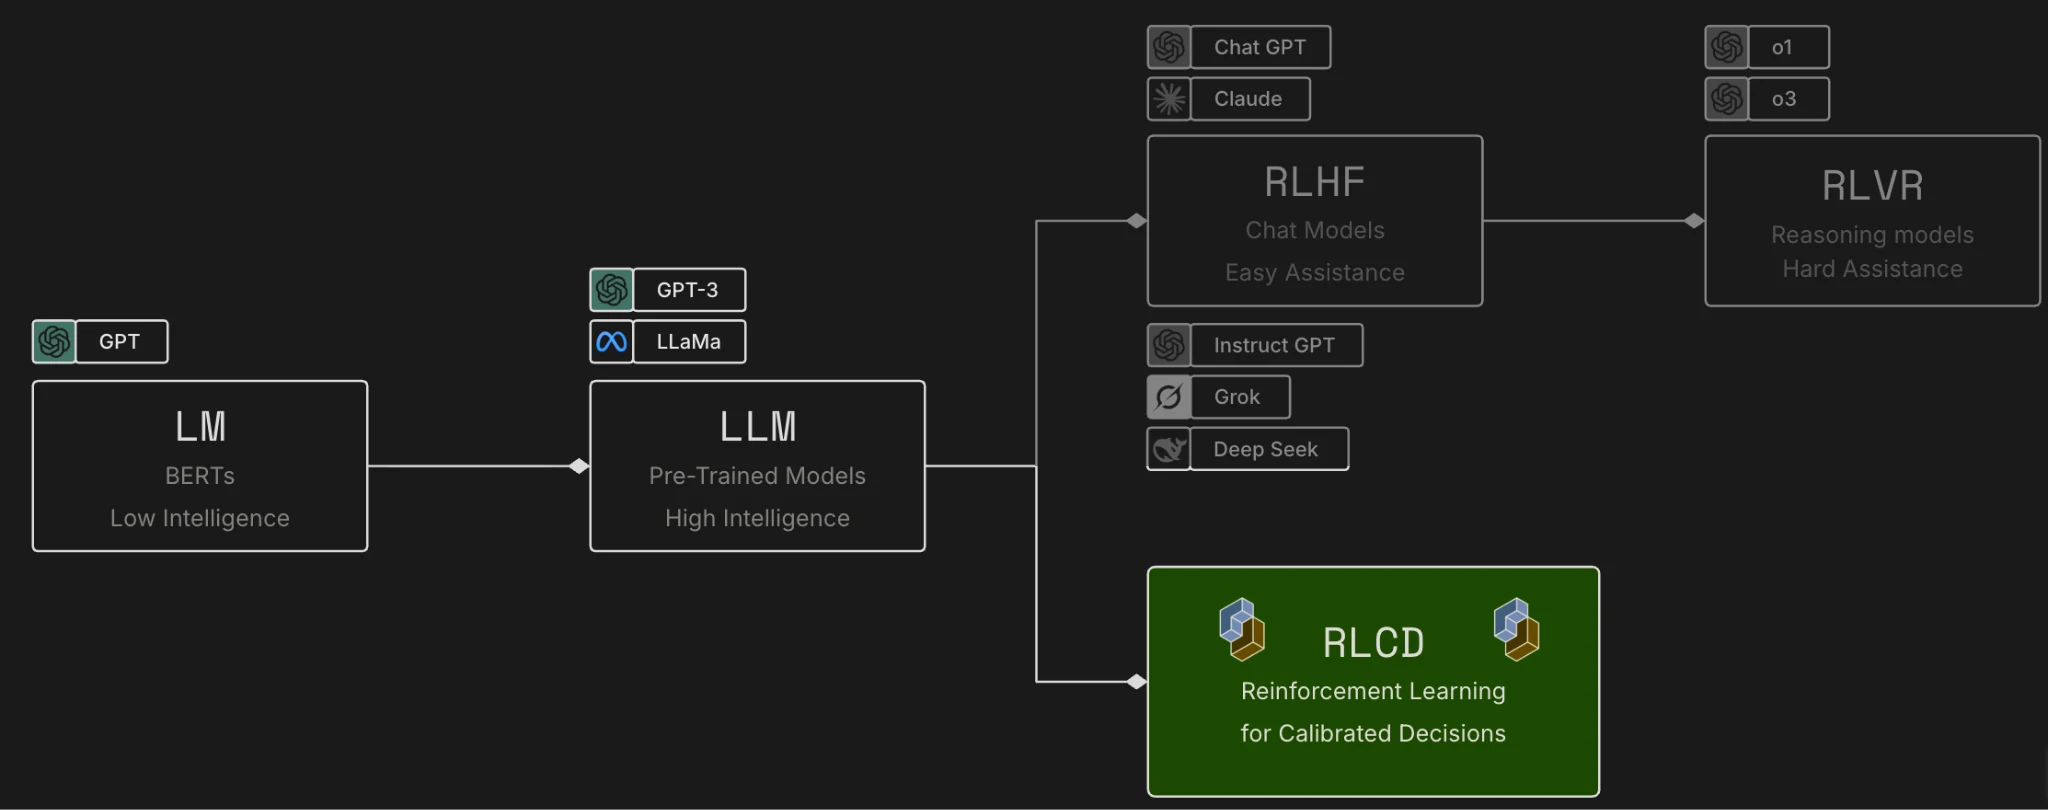
같은 청구 건을 15번 반복해 물었더니 Jev는 거의 같은 확률을 냈습니다. 질문별 표준편차 평균으로 따지면 Jev는 0.0102로, 비교한 AI 조건 전부보다 덜 흔들렸어요.
그래도 Jev가 오락가락할 때는 있습니다. "이 손해가 보장 대상인가"라는 질문에는 Jev가 0.43과 0.53 사이를 오가며 0.5 기준선을 넘나들었어요.
그래서 저는 기준선을 두 개 둡니다.
- 0.30 미만: 아니오로 자동 처리
- 0.70 초과: 예로 자동 처리
- 그 사이: 사람이 검토
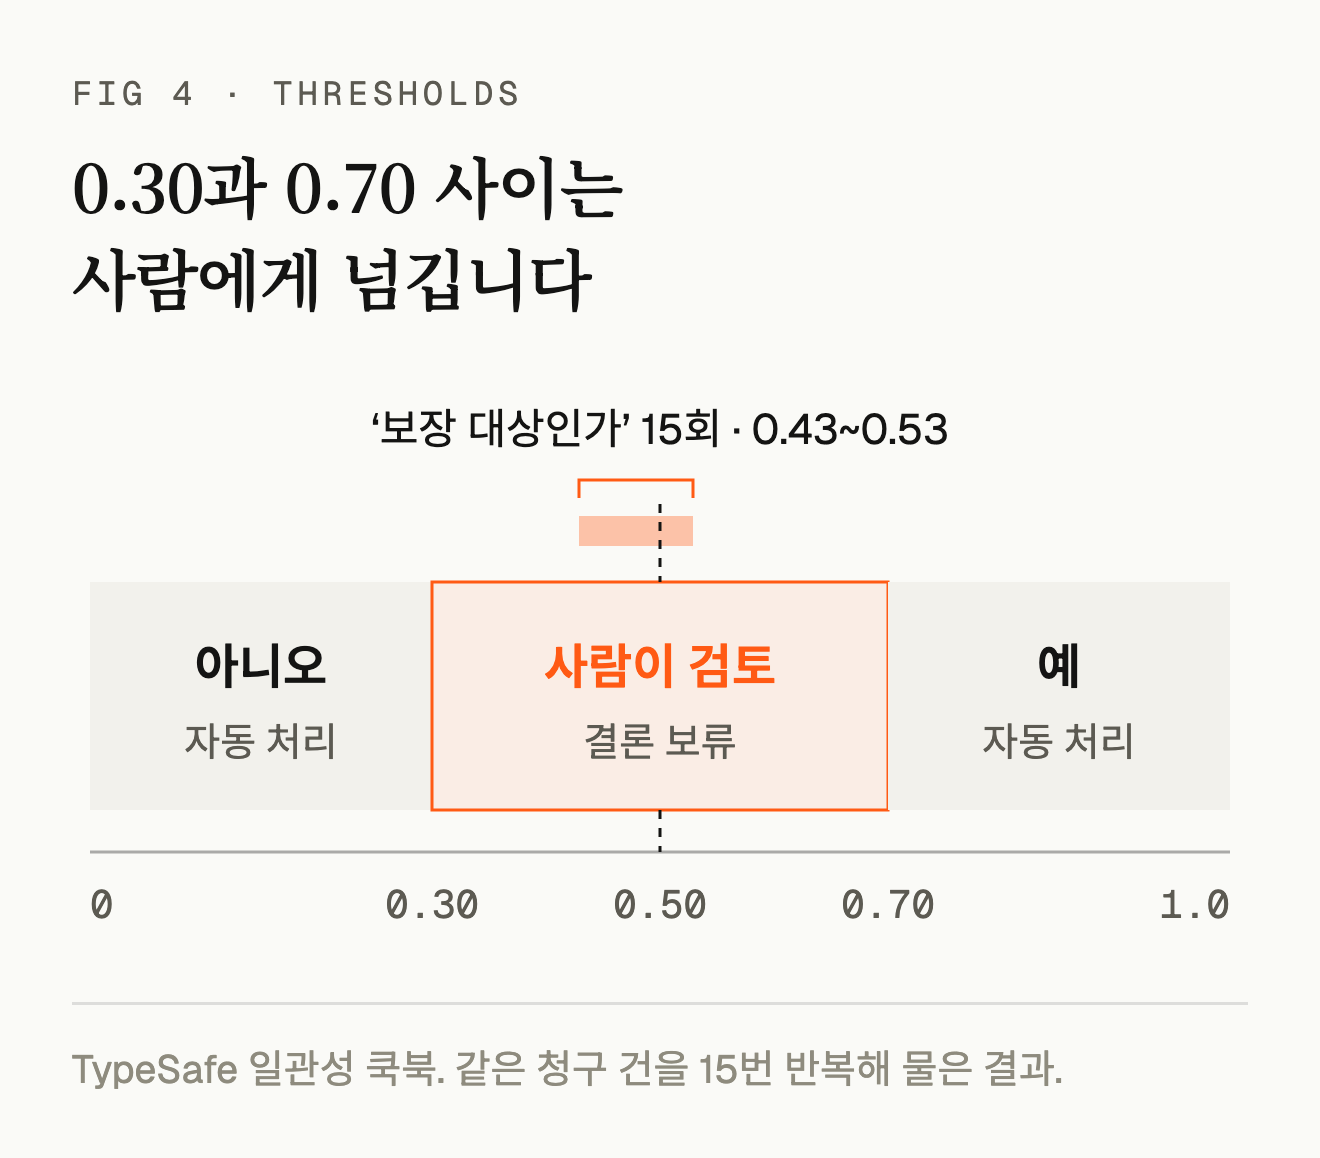
애매하면 결론을 내리지 않고 사람에게 넘깁니다. Jev가 답마다 확률을 매겨 주니 코드 몇 줄로 이 분기를 만들 수 있어요.
다만 이 확률을 어디까지 믿을지는 따져 봐야 합니다. 보정(Calibration)은 여러 답을 묶었을 때의 비율이에요. TypeSafe도 공식 문서에 개별 답은 보장하지 않는다고 적어 뒀습니다.
게다가 TypeSafe는 보정 데이터를 아직 공개하지 않았어요. 제이 반 질은 4천만 달러를 투자받은 모델이 보정된 확신도를 내세우면서 보정 오차 도표 하나 내놓지 않았다고 꼬집었습니다.
판단 근거도 볼 수 없습니다. Jev는 확률만 돌려주고, 입력의 어느 대목을 보고 판단했는지는 알려 주지 않아요. 채용 심사처럼 편향이 곧바로 누군가의 피해가 되는 일에는 쓰지 않는 게 맞습니다.
판단이 싸지면 더 자주 묻게 됩니다
TypeSafe는 경제학자 제번스에서 Jev라는 이름을 따왔습니다. 사람들이 석탄 기관을 효율적으로 바꾸자 석탄을 덜 쓰기는커녕 훨씬 더 태웠다는, 그 제번스 역설이요.
저도 그랬습니다. 판단이 비쌀 땐 코드 규칙으로 때우고 넘어갔어요. 싸지니까 규칙 세 개를 전부 모델에게 묻고 있습니다.
TypeSafe도 이런 소프트웨어를 그립니다. 사람이 짠 규칙만 도는 소프트웨어와 AI가 모든 걸 떠맡는 에이전트 사이에서, 싼 판단을 코드 곳곳에 심는 구조예요.
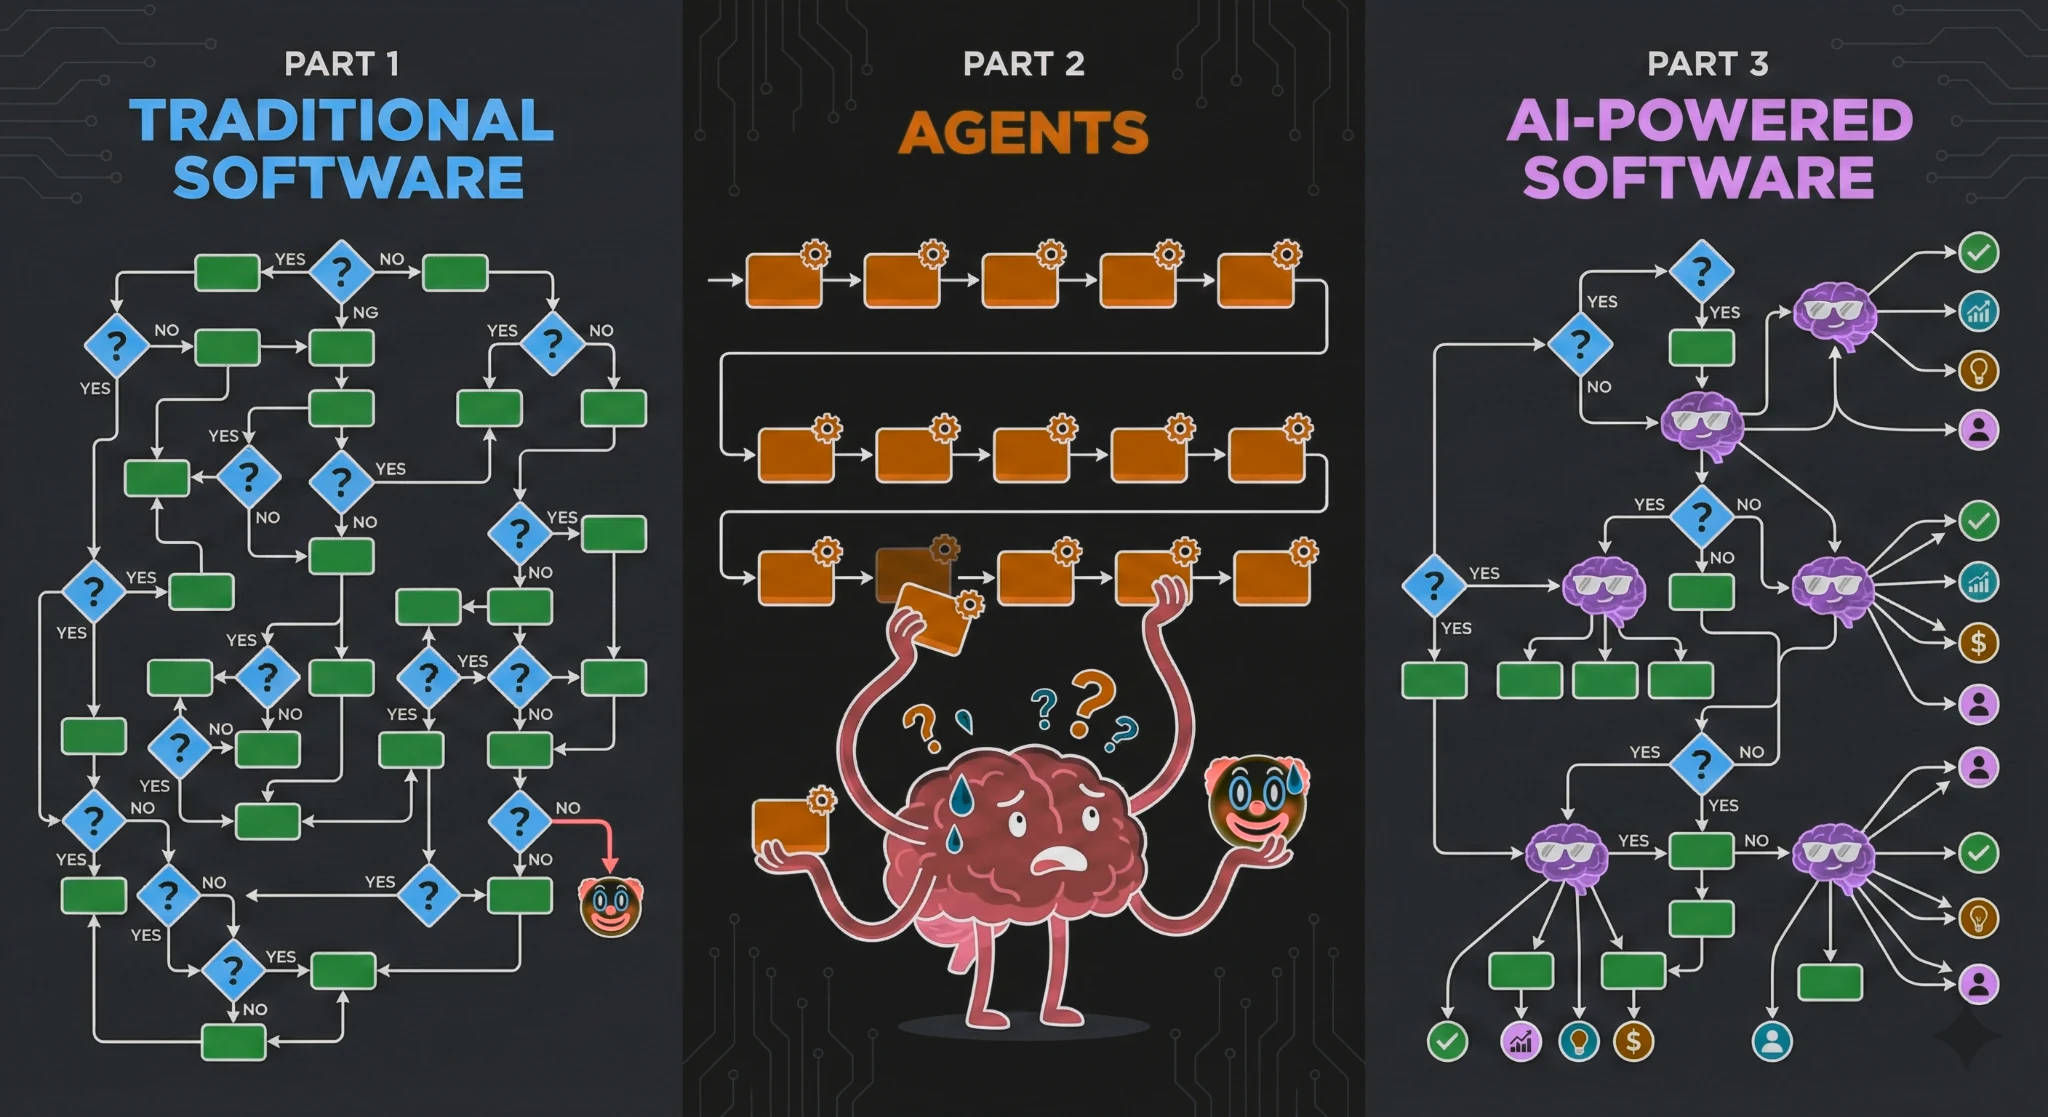
이제 저는 이 판단에 AI가 꼭 필요한지부터 따집니다.
출처
- TypeSafe 공식: 모델·가격 · 실패 유형 · 일관성 쿡북 · AI Primer · 워크플로 평가
- 독립 측정: Aman Kumar · LiteLLM · Near Here
- 비판: 보정 데이터 미공개
FAQ
자주 묻는 질문
- 확률이 0.5 근처로 나오면 어떻게 하나요?
- 결론을 내리지 말고 사람에게 넘기세요. 같은 질문을 15번 반복해도 0.43~0.53을 오간 사례가 있습니다. 0.30과 0.70을 기준선으로 두고 시작하면 됩니다.
- 판단 근거는 볼 수 있나요?
- 볼 수 없습니다. Jev는 확률만 돌려주고, 입력의 어느 대목을 보고 판단했는지는 알려 주지 않아요. 편향이 곧바로 피해가 되는 일에는 쓰지 않는 게 맞습니다.
- 한국어에도 쓸 수 있나요?
- TypeSafe는 공식 문서에 영어가 주력이고 한중일 문자는 처리하지만 같은 수준은 아니라고 적어 뒀습니다. 한국어 데이터라면 정확도부터 직접 확인하고, 확률이 애매한 구간은 사람에게 넘기세요.
SEASON 3
시즌3 「콘텐츠로 팔기」
AI와 콘텐츠를 만들고 고객에게 연결하는 4주
제가 에이전트로 조사하고 쓰고 파는 과정을 그대로 보여 드려요. 그다음 각자의 주제로 같이 만들어 봐요.
10월 2일 OT · 10월 5일부터 월·수 4주 · 10월 31일 오프라인
시즌3 커리큘럼 보기